บล็อก
ขั้นตอนถอดเสียงพอดแคสต์แบบครบวงจร
ผู้เขียน: Hushscript เผยแพร่: ตรวจสอบล่าสุด:
การถอดเสียงพอดแคสต์ไม่ใช่การตัดสินใจเพียงครั้งเดียว แต่เป็นห่วงโซ่ของการตัดสินใจหลายอย่าง: ข้อความร่างต้องแม่นยำแค่ไหน ใครเป็นคนตรวจแก้ ผู้พูดแต่ละคนถูกตั้งชื่ออย่างไร ข้อความจบลงในรูปแบบไหน และคุณยินดีทำซ้ำขั้นตอนเหล่านั้นทุกสัปดาห์มากแค่ไหน ทำห่วงโซ่นี้ให้ถูกต้องเพียงครั้งเดียว แล้วข้อความถอดเสียงจะใช้เวลาไม่กี่นาทีต่อตอน ทำพลาด แล้วทุกตอนจะกลายเป็นช่วงเวลาแก้ไขที่ไม่มีใครวางแผนไว้
เหตุใดผู้จัดพอดแคสต์จึงถอดเสียงตอนต่างๆ
เครื่องมือค้นหาจัดทำดัชนีข้อความ ไม่ใช่เสียง ข้อความถอดเสียงคือสิ่งที่ทำให้คนหาตอนของคุณเจอได้จากหัวข้อ ชื่อแขกรับเชิญ หรือประโยคที่จำได้เพียงครึ่งเดียว และเรื่องนี้ยิ่งสำคัญขึ้นเมื่อคลังตอนเก่าของคุณโตจนเกินจุดที่ใครจะไล่ดูทีละตอนได้
การเข้าถึงได้คืออีกครึ่งหนึ่งของเรื่องนี้ ผู้ฟังที่หูหนวกหรือบกพร่องทางการได้ยินต้องการข้อความ เช่นเดียวกับผู้ที่ไม่ได้ใช้ภาษานั้นเป็นภาษาแม่ คนที่ฟังอยู่ในที่เสียงดัง และใครก็ตามที่อ่านได้เร็วกว่าที่คุณพูด แนวทางของ Section 508 เรื่องคำบรรยายและข้อความถอดเสียง ถือว่าข้อความถอดเสียงเป็นทางเลือกที่เทียบเท่าสำหรับเนื้อหาที่มีแต่เสียง และคาดหวังให้มนุษย์ตรวจทานฉบับร่างอัตโนมัติ แทนที่จะปล่อยผลลัพธ์ดิบจากเครื่องออกไปตรงๆ
ข้อความถอดเสียงที่สะอาดยังเป็นวัตถุดิบด้วย:
- บล็อกโพสต์ที่สร้างจากช่วงที่พูดยาวเกินไป
- คำพูดสำหรับโซเชียลมีเดียที่ถ้อยคำตรงเป๊ะ
- สรุปสำหรับจดหมายข่าว
- โน้ตประกอบตอนและเครื่องหมายบท
- คำแปลสำหรับผู้ฟังที่อ่านภาษาหนึ่งได้ดีกว่าฟัง
และมันคือคลังเก็บถาวรด้วย สองปีต่อมาคุณยังค้นหาตอนเก่าของตัวเองเพื่อหาตัวเลขที่คุณเคยอ้างอิง เรื่องราวที่อยากย้อนกลับไปฟังอีกครั้ง หรือคำพูดของแขกรับเชิญที่คุณจำได้เพียงครึ่งเดียว
สิ่งที่การรู้จำเสียงพูดทำได้ถูกต้อง และสิ่งที่ทำไม่ได้
การรู้จำเสียงพูดอัตโนมัติดีพอที่จะใช้เป็นฐานในการเผยแพร่ แต่ไม่ดีพอที่จะเผยแพร่โดยไม่มีใครตรวจอ่าน งานศึกษาที่วัดความแม่นยำของโซลูชันการรู้จำเสียงพูดอัตโนมัติในผู้ให้บริการสิบเอ็ดรายพบว่าความแม่นยำแตกต่างกันมากระหว่างผู้ให้บริการแต่ละราย และยิ่งลดลงเมื่อใช้งานแบบสตรีมมิง ซึ่งเป็นข้อเท็จจริงที่ช่วยแก้ความเข้าใจผิดที่ว่าการถอดเสียงด้วยเครื่องมีคุณภาพระดับเดียวคงที่
คุณภาพขึ้นอยู่กับการบันทึกเป็นหลัก ไม่ใช่เครื่องมือ เสียงที่สะอาดและมี crosstalk น้อยย่อมดีกว่างานสดที่มีเสียงรบกวนในห้อง พิธีกรคนเดียวพูดแล้วอ่านง่ายกว่าการโต้วาทีสี่ทาง บทสนทนาทั่วไปถอดเสียงได้สะอาดกว่าเนื้อหาหนึ่งชั่วโมงที่เต็มไปด้วยชื่อยา การอ้างอิงคดีความ หรือศัพท์เฉพาะของผลิตภัณฑ์
| สิ่งที่มีผลต่อฉบับร่าง | มากน้อยแค่ไหน | สิ่งที่คุณทำได้ |
|---|---|---|
| คุณภาพเสียง | มาก | บันทึกในที่เงียบ ด้วยไมโครโฟนจริง |
| คนพูดทับกัน | มาก | ตกลงเรื่องการผลัดกันพูด ตัดช่วง crosstalk ที่แย่ที่สุดออกก่อนอัปโหลด |
| สำเนียงและภาษาถิ่น | บ้าง | เลือกบริการที่มีโมเดลหลายภาษาที่แข็งแกร่ง |
| ศัพท์เฉพาะทาง | บ้าง | ใส่ชื่อและคำศัพท์ลงในพจนานุกรมก่อนเริ่มงาน |
| จังหวะการพูด | เล็กน้อย | พูดจังหวะปกติไม่มีปัญหา มีแต่การพูดเร็วมากเท่านั้นที่ทำให้แม่นยำลดลง |
สำเนียงและการจัดการคำพูดติดขัดเป็นสองจุดที่โมเดลทั่วไปเสียความแม่นยำเร็วที่สุด หากรายการของคุณมีแขกรับเชิญจากต่างประเทศ ให้กันเวลาไว้ตรวจทานแทนที่จะสันนิษฐานว่าฉบับร่างสะอาดอยู่แล้ว Hushscript ให้คุณบันทึกพจนานุกรมของชื่อ แบรนด์ และศัพท์เฉพาะที่เกิดซ้ำ แล้วนำไปใช้ก่อนถอดเสียง ซึ่งเป็นวิธีซื้อความแม่นยำที่ถูกที่สุดที่คุณจะหาได้
ป้ายกำกับผู้พูด และจุดที่มักผิดพลาด
การแยกเสียงผู้พูดจะแยกแต่ละเสียงโดยอัตโนมัติ และแยกบทสัมภาษณ์สองคนได้ถูกต้องเกือบทุกครั้ง มันจะผิดพลาดเมื่อแขกสองคนมีเสียงคล้ายกัน เมื่อผู้คนหัวเราะทับกัน และเมื่อการหยุดพูดนานทำให้เสียงเดียวดูเหมือนสองเสียง
ป้ายกำกับที่ได้จะเป็นชื่อทั่วไป และเมื่อเปลี่ยนชื่อครั้งเดียวจะเปลี่ยนทุกที่ที่ปรากฏ ดังนั้นบทสนทนาสองคนใช้เวลาตั้งชื่อประมาณหนึ่งนาที ส่วนแผงสี่คนใช้เวลาไม่กี่นาที Hushscript รวมป้ายกำกับผู้พูดไว้ฟรีในทุกข้อความถอดเสียง โดยไม่มีค่าธรรมเนียมต่อผู้พูดและไม่จำกัดจำนวนเสียง สำหรับกลไกเบื้องหลัง ดูที่การแยกผู้พูดทำงานอย่างไร
เลือกแนวทาง
แบบแมนนวล คุณหรือผู้พิมพ์ที่จ้างมาพิมพ์ทุกคำเอง ช้าที่สุด แพงที่สุด แต่น่าเชื่อถือที่สุดกับเสียงที่ยาก มันคุ้มค่ากับต้นทุนในบันทึกทางกฎหมายและทางการแพทย์ที่คำผิดหนึ่งคำเป็นปัญหาจริง และแทบไม่คุ้มเลยกับพอดแคสต์
แบบผสม เครื่องพิมพ์ฉบับร่าง คนตรวจทาน นี่คือจุดที่รายการเกือบทุกแบบควรอยู่ เครื่องทำหน้าที่พิมพ์ ส่วนคุณทำหน้าที่ตัดสินใจ: แก้คำพ้องเสียง เติมคำปฏิเสธที่หายไปกลับเข้าไป แก้ไขชื่อบริษัทของแขกให้ถูกต้อง และตัดสินใจว่าจะเก็บคำเติมไว้มากแค่ไหน
แบบอัตโนมัติดิบ อัปโหลด ดาวน์โหลด เผยแพร่ ใช้ได้ดีสำหรับอ้างอิงภายในหรือทำดัชนีตอนคร่าวๆ แต่เสี่ยงหากใช้เป็นข้อความสาธารณะ เพราะข้อผิดพลาดที่หลงเหลืออยู่มักเป็นแบบที่ดูสมเหตุสมผลจนสังเกตไม่ออก
รายการส่วนใหญ่ลงเอยด้วยการผสมสองแบบหลัง: ตรวจทานอย่างเต็มที่สำหรับตอนที่นำไปโปรโมต และปล่อยข้อความถอดเสียงที่ยังไม่ตรวจทานไว้สำหรับส่วนที่เหลือของคลัง
จ่ายตามการใช้งาน หรือแบบสมัครสมาชิก
การสมัครสมาชิกคาดเดาได้และเรียกเก็บเงินคุณแม้ในเดือนที่คุณไม่ได้เผยแพร่อะไรเลย ส่วนแบบจ่ายตามการใช้งานจะเรียกเก็บเฉพาะตอนที่คุณถอดเสียง ซึ่งเหมาะกับรายการตามฤดูกาล ตารางที่ไม่แน่นอน หรือช่วงพักหน้าร้อน
คิดต้นทุนต่อตอนแทนที่จะคิดต่อเดือน ถ้าคุณเผยแพร่ทุกสัปดาห์ การสมัครสมาชิกอาจถูกกว่า ถ้าคุณเผยแพร่ตามใจชอบ แพ็กเกจนาทีแบบเติมเงินล่วงหน้า ให้คุณซื้อโควตาไว้ล่วงหน้าโดยไม่ต้องผูกแผนใดๆ นาทีมีอายุใช้งาน 365 วัน และการถอดเสียงที่เสร็จสมบูรณ์หรือการซื้อใหม่ทุกครั้งจะรีเซ็ตช่วงเวลานั้น
สร้างขั้นตอนการทำงาน
ขั้นตอนการทำงานหลัก ตั้งแต่ต้นจนจบ:
- บันทึกและเตรียมเสียงให้สะอาด: ตัดบทสนทนาช่วงเตรียมตัวและความเงียบยาวๆ ออก แล้วส่งออกเป็น MP3, M4A หรือ WAV หรือปล่อยให้แทร็กเสียงของวิดีโอถูกแยกออกมาโดยอัตโนมัติ
- อัปโหลดไฟล์และให้ระบบรู้จำเสียงพูดสร้างฉบับร่าง โดยแยกผู้พูดออกจากกันโดยอัตโนมัติ
- ตรวจทานฉบับร่างเทียบกับเสียง แก้ไขคำพ้องเสียง คำปฏิเสธที่หายไป และคำนามเฉพาะที่ผิดเพี้ยน
- ตัดสินใจว่าจะใช้แบบเกลาคำหรือแบบคำต่อคำ แล้วจัดรูปแบบข้อความให้เหมาะกับปลายทางถัดไป: โน้ตประกอบตอน หน้าข้อความถอดเสียงเดี่ยว หรือคำบรรยายที่มีการกำหนดเวลา
- ตรวจสอบความคาดหวังของแขกรับเชิญและสิทธิ์ใดๆ ที่ผูกกับการบันทึก จากนั้นจึงเผยแพร่
ก่อนอัปโหลด
เริ่มจากเสียงที่สะอาด ตัดช่วงเงียบยาวๆ การเริ่มพูดที่ผิดพลาด และบทสนทนาก่อนเข้าเรื่องออกไปก่อนที่บทสัมภาษณ์จะเริ่มขึ้นจริง เสียงที่สั้นลงหมายถึงข้อความให้อ่านน้อยลง และช่วงที่ไม่เกี่ยวข้องให้ลบทิ้งภายหลังน้อยลง
ส่งออกเป็น MP3, M4A หรือ WAV วิดีโอก็ใช้ได้เช่นกัน และ Hushscript จะดึงแทร็กเสียงออกมาในเบราว์เซอร์ของคุณ ดังนั้นไฟล์วิดีโอจึงไม่ต้องอัปโหลดเลย แต่การส่งออกเป็นเสียงจะส่งมอบได้เร็วกว่าหากคุณมีอยู่แล้ว มิกซ์เซสชันที่มีหลายแทร็กให้รวมเป็นแทร็กเดียวก่อน เว้นแต่คุณต้องการให้แต่ละแทร็กถูกถอดเสียงแยกกันโดยเฉพาะ
ตั้งชื่อไฟล์ด้วยรูปแบบเดียวกันทุกครั้ง:
- วันที่บันทึก เพื่อให้โฟลเดอร์เรียงตามลำดับเวลา
- หมายเลขตอน
- ชื่อแขกรับเชิญหรือหัวข้อ
- เครื่องหมายระบุเวอร์ชัน หากมีการตัดต่อมากกว่าหนึ่งฉบับ
ตัวอย่างเช่น 2026-06-18-e047-jordan-chen-final.mp3 เรื่องเล็กน้อยตอนที่คุณมีแค่สี่ตอน แต่เป็นความแตกต่างระหว่างหาเจอกับหาไม่เจอเมื่อคุณมีสองร้อยตอนแล้ว
ตรวจทานฉบับร่าง
อ่านข้อความถอดเสียงไปพร้อมกับเปิดเสียงฟัง ข้อผิดพลาดที่ดูผิดสังเกตได้บนหน้ากระดาษเป็นแบบที่แก้ง่าย ส่วนข้อผิดพลาดที่อันตรายจะอ่านลื่นไหลสมบูรณ์แบบแต่ความหมายกลับตรงข้ามกับสิ่งที่พูดจริง: คำพ้องเสียง คำปฏิเสธที่หายไป และคำนามเฉพาะที่ผิดเพี้ยน คือสามอย่างที่มักหลุดรอดไปจนถูกเผยแพร่
ข้อผิดพลาดมักรวมกลุ่มกัน จึงควรอ่านตรงจุดที่มันรวมตัวกันและอ่านผ่านๆ ส่วนที่เหลือ ช่วงเปิดและปิดรายการมักมีชื่อ ตำแหน่ง และ URL ที่พูดออกเสียง ช่วงเนื้อหาเชิงเทคนิคมีศัพท์เฉพาะและตัวเลข ส่วน Crosstalk และเสียงหัวเราะมักให้ผลลัพธ์ที่อ่านไม่ได้ ซึ่งมักต้องการลบทิ้งมากกว่าซ่อมแซม
ตรวจสอบป้ายกำกับไปพร้อมกัน ยืนยันว่าเสียงถูกแยกออกจากกันถูกต้อง แทนที่ป้ายกำกับทั่วไปด้วยชื่อจริง และรวมผู้พูดที่ถูกแยกออกเป็นสองคนหลังจากหยุดพูดนานเข้าด้วยกัน
จากนั้นตัดสินใจว่าข้อความควรตรงตามคำพูดจริงแค่ไหน การถอดเสียงแบบเกลาคำกับแบบคำต่อคำ อธิบายข้อแลกเปลี่ยนนี้ไว้: แบบคำต่อคำเก็บทุกคำอ้ำอึ้งและการเริ่มพูดผิดไว้ครบ ส่วนแบบเกลาคำจะตัดสิ่งเหล่านั้นออกและจัดไวยากรณ์ให้เรียบร้อย พอดแคสต์ส่วนใหญ่ต้องการแบบหลัง ผู้ฟังของคุณไม่จำเป็นต้องได้ยินทุกจุดติดขัดในการพูด และแขกรับเชิญของคุณก็จะขอบคุณคุณอยู่ในใจ
จัดรูปแบบให้ผู้อ่าน
กำแพงข้อความล้วนค้นหาได้แต่อ่านไม่รู้เรื่อง ให้โครงสร้างกับมัน:
- การประทับเวลา ที่จุดเปลี่ยนหัวข้อ หรือตามช่วงเวลาที่กำหนดไว้
- ชื่อผู้พูด ตัวหนาไว้ก่อนแต่ละช่วงพูด
- การขึ้นย่อหน้าใหม่ ตรงจุดที่บทสนทนาเปลี่ยนทิศทางจริงๆ
- หัวข้อย่อย สำหรับแต่ละช่วงที่แยกจากกันของตอน
จากนั้นจัดรูปแบบให้เข้ากับปลายทาง โน้ตประกอบตอนต้องการหัวข้อย่อยและสัญลักษณ์หัวข้อ หน้าข้อความถอดเสียงเดี่ยวๆ ต้องการคำนำสั้นๆ และลิงก์ไปยังตัวเล่นเสียง คำบรรยายต้องการรูปแบบที่มีการกำหนดเวลา เช่น SRT หรือ VTT
สิทธิ์ แขกรับเชิญ และสิ่งที่คุณเผยแพร่
ข้อความถอดเสียงเป็นงานที่ต่อยอดจากการบันทึกเสียง ดังนั้นข้อจำกัดใดๆ ที่ใช้กับการบันทึกเสียงมักจะติดตามมาด้วย หากตอนใดมีเพลงที่มีลิขสิทธิ์ คลิป หรือเสียงของบุคคลที่สามอยู่ ให้ตรวจสอบก่อนว่าสัญญาอนุญาตครอบคลุมอะไรบ้าง ก่อนที่คุณจะเผยแพร่ข้อความของมัน
ตกลงความคาดหวังกับแขกรับเชิญตั้งแต่ตอนขออนุญาตเผยแพร่ ไม่ใช่ทีหลัง แขกบางคนมีเหตุผลที่ต้องการเห็นข้อความถอดเสียงก่อนเผยแพร่ โดยเฉพาะเมื่อพวกเขาพูดในฐานะตัวแทนทางการ หรือพูดถึงเรื่องที่ละเอียดอ่อน ตกลงกันไว้ล่วงหน้าเร็วกว่าการเจรจากันทีหลังเมื่อหน้าเพจขึ้นออนไลน์แล้วมาก
และข้อความถอดเสียงที่เผยแพร่แล้วจะถาวร เปิดเผยต่อสาธารณะ และนำไปอ้างอิงได้ในแบบที่เสียงทำไม่ได้ หากตอนใดพาดพิงถึงงานวิจัยที่ยังไม่เผยแพร่ รายละเอียดลูกค้า หรือตัวเลขที่คุณยังไม่ได้ประกาศ ให้ตรวจทานก่อนเผยแพร่ ปิดบังช่วงนั้น หรือเก็บข้อความถอดเสียงของตอนนั้นไว้เป็นการภายใน
ตอนที่มีหลายภาษา
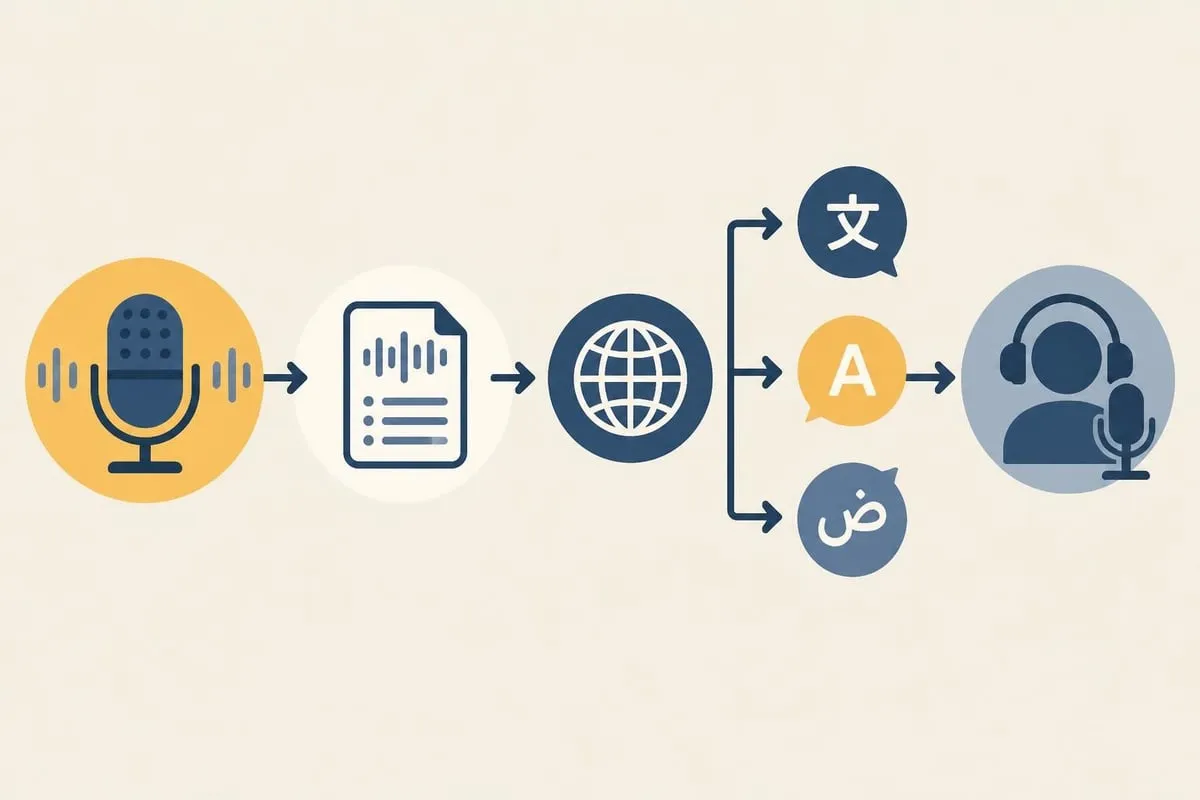
ถอดเสียงในภาษาต้นฉบับก่อน วิธีนี้จะให้เอกสารต้นฉบับที่แม่นยำเพียงชุดเดียว แทนที่จะแปลจากฉบับร่างที่ไม่มั่นคงแล้วขยายข้อผิดพลาดออกไปในทุกสาขา Hushscript รองรับประมาณ 99 ภาษาพูดด้วยการตรวจจับอัตโนมัติ และแต่ละภาษาปลายทางที่คุณเพิ่มสำหรับการแปลมีค่าใช้จ่าย 25% ของความยาวการบันทึก นอกเหนือจากค่าถอดเสียงเอง
หากรายการของคุณมีการสลับภาษาไปมา หรือพิธีกรของคุณพูดได้สองภาษา ให้ตรวจสอบว่าบริการที่คุณใช้จัดการกับการเปลี่ยนภาษากลางตอนอย่างไร บางบริการตรวจจับได้เอง บางบริการต้องการให้แบ่งเสียงตามภาษาไว้ล่วงหน้าก่อนส่งเข้าไป
ขั้นตอนการแปลที่ใช้งานได้จริง:
- ถอดเสียงภาษาต้นฉบับและตรวจทานให้เรียบร้อย
- แปลเป็นภาษาปลายทางที่ต้องการ
- ให้เจ้าของภาษาอ่านคำแปลแต่ละภาษาเพื่อตรวจน้ำเสียงและสำนวน
- เผยแพร่คำแปลควบคู่ไปกับข้อความถอดเสียงต้นฉบับ
ตอนที่ไม่ควรเปิดเผยต่อสาธารณะ
ไม่ใช่ทุกการบันทึกที่ควรอยู่ในคลังถาวร เรื่องราวส่วนตัว กรณีศึกษาของลูกค้า และช่วงพูดคุยนอกบันทึก ล้วนควรได้รับการจัดการต่างจากบทสัมภาษณ์รายสัปดาห์ทั่วไป
โหมดส่วนตัวถูกสร้างมาเพื่อสิ่งนี้โดยเฉพาะ การรู้จำเสียงพูดยังคงทำงานในฐานะบริการ แต่ไม่มีอะไรถูกบันทึกลงในบัญชีของคุณเลย: ผลลัพธ์จะมาในรูปไฟล์ .husharchive ที่มีรหัสผ่านป้องกันให้คุณดาวน์โหลด และมันจะหมดอายุหากคุณไม่ดาวน์โหลด ในเส้นทางปกติ สำเนาเสียงที่ใช้ถอดเสียงจะถูกลบทันทีที่ข้อความถอดเสียงถูกบันทึก เนื้อหาข้อความถอดเสียงที่จัดเก็บไว้จะเข้ารหัสขณะจัดเก็บ และคุณเลือกได้ว่าจะเก็บข้อความถอดเสียงไว้จนกว่าคุณจะลบเอง หรือให้ลบอัตโนมัติหลังผ่านไป 7, 30, 90 หรือ 365 วัน
รูปแบบการส่งออก
สิ่งที่คุณทำต่อได้กับข้อความถอดเสียงในภายหลัง ขึ้นอยู่กับสิ่งที่ได้ออกมาตั้งแต่แรก ข้อความล้วนใช้ได้สากลแต่สูญเสียทุกอย่างที่อยู่รอบคำพูดไป รูปแบบที่มีการกำหนดเวลาจะเก็บจังหวะเวลาไว้ รูปแบบที่มีโครงสร้างจะเก็บข้อมูลเมทาดาต้าไว้ทั้งหมด
| รูปแบบ | เหมาะกับ | เก็บเมทาดาต้าหรือไม่ |
|---|---|---|
| TXT | เก็บถาวร วางข้อความดิบ | ไม่ |
| DOCX, PDF | แชร์กับคนที่จะไม่เปิดไฟล์ข้อมูล | บางส่วน |
| SRT, VTT | คำบรรยายและซับไตเติ้ล | จังหวะเวลา |
| JSON, XML | ป้อนเข้าเครื่องมืออื่น | ทั้งหมด |
| HTML | เผยแพร่ข้อความถอดเสียงเป็นหน้าเว็บ | โครงสร้างและการจัดรูปแบบ |
Hushscript ส่งออกได้ 21 รูปแบบ บวกไฟล์เก็บถาวรที่มีรหัสผ่านป้องกัน ดังนั้นการเลือกรูปแบบหนึ่งจึงเป็นแค่การดาวน์โหลด ไม่ใช่โปรเจกต์แปลงไฟล์ หากคุณเผยแพร่เวอร์ชันวิดีโอของตอน วิธีเพิ่มคำบรรยายลงในวิดีโอ ครอบคลุมเส้นทางของรูปแบบที่มีการกำหนดเวลาไว้ตั้งแต่ต้นจนจบ
หากคุณป้อนข้อความถอดเสียงเข้าเครื่องมือสรุปความ อินพุตสำคัญกว่าตัวเครื่องมือสรุปเสียอีก ข้อผิดพลาดจะแพร่กระจาย: ชื่อที่ผิดเพี้ยนในข้อความถอดเสียงจะกลายเป็นชื่อที่ผิดเพี้ยนในทุกบทสรุป การ์ดคำพูด และจดหมายข่าวที่สร้างต่อจากมัน
ต้องแม่นยำแค่ไหนถึงจะพอ
สำหรับข้อความถอดเสียงพอดแคสต์ที่เผยแพร่แล้ว คำผิดเป็นครั้งคราวยังพอทนได้ เพราะบริบทช่วยพาผู้อ่านผ่านไปได้ แต่เนื้อหาที่คนนำไปใช้ตัดสินใจจริง เช่น ทางการแพทย์ กฎหมาย หรือการเงิน ต้องการการตรวจทานที่เข้มงวดกว่า และผู้ตรวจที่รู้ศัพท์เฉพาะดีพอจะจับคำที่ถูกแทนที่แบบดูสมเหตุสมผลได้
วัดผลจริงแทนที่จะเดา สุ่มฟัง 5 นาที นับจำนวนคำ นับจำนวนที่ผิด แล้วหารจำนวนหนึ่งด้วยอีกจำนวนหนึ่ง ตัวเลขนั้นจะบอกคุณว่าการตรวจทานของคุณควรใช้เวลาหนึ่งชั่วโมงหรือสิบนาที และปัญหาของคุณอยู่ที่บริการหรือไมโครโฟน
นั่นคือประเด็นที่แท้จริง: ความแม่นยำถูกซื้อมาตั้งแต่ขั้นตอนการบันทึกเสียง ไม่มีบริการถอดเสียงใดกู้คืนคำที่ไม่เคยถูกบันทึกไว้ชัดเจนได้ และไมโครโฟนที่ดีกว่าในห้องที่เงียบกว่าย่อมช่วยข้อความถอดเสียงได้มากกว่าการเปลี่ยนผู้ให้บริการเสียอีก
มันคุ้มค่าหรือไม่
ติดตามผลจริงแทนที่จะสันนิษฐานเอาเอง ดูยอดเข้าชมหน้าข้อความถอดเสียง ตรวจสอบว่าตอนต่างๆ ติดอันดับสำหรับหัวข้อที่พูดถึงหรือไม่ และถามผู้ฟังว่าพวกเขาเจอคุณได้อย่างไร ข้อความถอดเสียงมักสร้างทราฟฟิกอย่างช้าๆ และยังคงสร้างต่อไปนานหลังจากตอนนั้นหลุดจากชาร์ตไปแล้ว
สิ่งที่ควรชั่งน้ำหนัก:
- เวลาที่ประหยัดได้จากการเขียนโน้ตประกอบตอนและโพสต์โซเชียล
- ทราฟฟิกจากการค้นหาที่เข้ามาที่หน้าข้อความถอดเสียง
- การเข้าถึงได้ และผู้ฟังกลุ่มใหม่ที่ตามมา
- คลังตอนเก่าของคุณเองที่ค้นหาได้
- การนำเนื้อหาไปใช้ซ้ำโดยเริ่มจากข้อความแทนที่จะเป็นเสียง
ต้นทุนการถอดเสียงเป็นรายการที่คุณเห็นทุกเดือน ส่วนผลตอบแทนนั้นกระจายตัวและมาถึงช้า ซึ่งเป็นเหตุผลว่าทำไมมันจึงถูกประเมินค่าต่ำไปได้ง่ายๆ
ขั้นตอนการทำงานที่อยู่รอดได้จริงเมื่อเจอตารางรายสัปดาห์คือแบบที่น่าเบื่อที่สุด: เสียงที่สะอาดเข้าไป ฉบับร่างจากเครื่อง ตรวจทานอย่างตั้งใจหนึ่งรอบ และรูปแบบที่เหมาะกับปลายทางที่ข้อความจะไปถึง Hushscript จัดการช่วงกลางของขั้นตอนนั้นให้ ด้วยป้ายกำกับผู้พูดฟรีในทุกข้อความถอดเสียง ประมาณ 99 ภาษา อัปโหลดได้สูงสุด 10 ชั่วโมง และนาทีแบบเติมเงินล่วงหน้าแทนการสมัครสมาชิก วางตอนไว้ที่หน้าถอดเสียงพอดแคสต์ แล้ว 5 นาทีแรกจะกลับมาพร้อมป้ายกำกับผู้พูดก่อนที่คุณจะสร้างบัญชีใดๆ
แหล่งข้อมูลและมาตรฐานอิสระ
Hushscript อ้างอิงแหล่งข้อมูลอิสระที่ไม่ใช่คู่แข่งเหล่านี้เพื่ออธิบายงานวิจัย มาตรฐาน หรือการทำงานของแพลตฟอร์ม โดยไม่ได้หมายความว่าแหล่งข้อมูลดังกล่าวรับรอง Hushscript
วันที่ตรวจสอบแหล่งข้อมูล: