ブログ
ポッドキャストの文字起こしワークフロー:始めから公開まで
著者: Hushscript 公開日: 最終確認日:
ポッドキャストの文字起こしは、一つの決断ではなく連鎖する決断の積み重ねです。下書きにどこまでの精度が必要か、誰がそれを整えるか、話者の名前をどう付けるか、テキストを最終的にどの形式にするか、そしてそれを毎週どこまで繰り返す気があるか。この連鎖を一度きちんと組み立てておけば、トランスクリプトはエピソードごとに数分の手間で済みます。組み立てを誤ると、毎回のエピソードが誰も予定していなかった編集作業に変わってしまいます。
ポッドキャスターが文字起こしをする理由
検索エンジンがインデックスするのはテキストであって、音声ではありません。トランスクリプトがあるからこそ、トピックやゲストの名前、うろ覚えの一言からエピソードを見つけてもらえます。バックカタログが増えて誰もブラウズしなくなる規模になった瞬間から、この重要性はさらに増します。
もう半分の理由はアクセシビリティです。聴覚障害や難聴のリスナーにはテキストが必要ですし、非母語話者、騒がしい場所で聴いている人、話すより速く読める人にも同じことが言えます。Section 508のキャプションとトランスクリプトに関するガイダンスは、トランスクリプトを音声専用コンテンツの同等の代替手段として扱っており、機械の生の出力ではなく人間によるチェックを経ることを求めています。
クリーンなトランスクリプトは素材にもなります:
- 長く続いたセグメントから作るブログ記事
- 一言一句そのままのSNS投稿用の引用
- ニュースレターの要約
- ショーノートとチャプターマーカー
- 聞くよりも読むほうが得意な言語のリスナー向けの翻訳
そしてそれはアーカイブでもあります。2年後になっても、自分の過去のエピソードから、引用した数字や読み返したいエピソード、うろ覚えのゲストの発言を検索できます。
音声認識が得意なことと苦手なこと
自動音声認識は、そのまま公開素材にできるほどの精度はありますが、確認せずに公開してよいほどではありません。自動音声認識ソリューションの精度を測定した研究では、11のサービスを対象に、ベンダー間で精度が大きくばらつき、ストリーミング利用ではさらに精度が落ちることが分かりました。機械による文字起こしを一律の品質だと考えるのは誤りだと気づかせてくれるデータです。
精度を左右するのは主にツールではなく録音そのものです。クロストークの少ないクリーンな音声は、部屋の雑音が入るライブイベントの録音より優れた結果になります。一人語りのホストは、4人が入り乱れる討論より読みやすい結果になります。日常会話は、薬品名や判例、専門用語だらけの1時間より、はるかにきれいに文字起こしされます。
| 下書きに影響するもの | どれくらい影響するか | できる対策 |
|---|---|---|
| 音声の品質 | 大きい | 静かな場所で、きちんとしたマイクを使って録音する |
| 話者同士の発言のかぶり | 大きい | 発言の順番を決めておき、アップロード前にひどいクロストークを削る |
| アクセントや方言 | 中くらい | 多言語モデルが強いサービスを選ぶ |
| 専門用語 | 中くらい | 実行前に名前や用語を辞書に登録しておく |
| 話す速さ | 小さい | 通常の速さなら問題なく、極端に速い場合だけ精度が下がる |
アクセントと言い淀みへの対応は、汎用モデルが最も精度を落としやすい2つのポイントです。海外のゲストを迎える番組なら、下書きがきれいだと決めつけず、レビューの時間をあらかじめ確保しておきましょう。Hushscriptでは、名前やブランド名、繰り返し出てくる専門用語を辞書として保存し、文字起こしの前に適用できます。これは、精度を買う方法としては最も安上がりです。
話者ラベルとそのずれどころ
ダイアライゼーションは自動的に声を分離し、2人によるインタビューであればほぼ確実に正しく処理します。ずれが生じるのは、2人のゲストの声がよく似ている場合、複数人が同時に笑っている場合、そして長い間があって1つの声が2つの話者に見えてしまう場合です。
ラベルは汎用的な形で返ってくるので、1か所を実名に変更すればすべての出現箇所に反映されます。2人の対談なら名前を付け直すのに1分ほど、4人のパネルでも数分で済みます。Hushscriptは、話者ごとの追加料金や声の数の上限なしに、すべてのトランスクリプトへ話者ラベルを無料で付けます。仕組みの詳細については話者ダイアライゼーションの仕組みをご覧ください。
アプローチを選ぶ
**手動。**自分自身か、雇った文字起こし担当者がすべての言葉を入力します。最も遅く、最も高価で、難しい音声でも最も確実です。1語の間違いが本当に問題になる法律や医療の記録ではその費用に見合いますが、ポッドキャストで見合うことはほとんどありません。
**ハイブリッド。**機械が下書きを作り、人間がレビューします。ほとんどの番組が落ち着くべきはここです。入力は機械が担い、判断は自分が下します。同音異義語の修正、抜け落ちた否定形の復元、ゲストの会社名の訂正、フィラーをどこまで残すかの判断です。
**自動そのまま。**アップロードして、ダウンロードして、公開する。社内資料やエピソードの大まかな索引としては十分です。生き残る誤りは一見もっともらしいものばかりなので、公開テキストとしてはリスクがあります。
ほとんどの番組は、後者の2つを組み合わせることに落ち着きます。宣伝するエピソードには全面的なレビューを行い、アーカイブの残りは未レビューのトランスクリプトのままにするのです。
従量課金かサブスクリプションか
サブスクリプションは予測しやすい一方、公開しない月にも料金が発生します。従量課金は文字起こしをした分だけ請求されるので、季節限定の番組や不定期のスケジュール、夏休みのある番組に向いています。
コストは月単位ではなく、エピソード単位で計算しましょう。毎週公開するならサブスクリプションのほうが安くなることもあります。気が向いたときに公開するタイプなら、プリペイド分数パックを使えば、プランに縛られずに前もって容量を購入できます。分数は365日間有効で、文字起こしを完了するか新たに購入するたびに、この期限がリセットされます。
ワークフローを組み立てる
コアとなるワークフローを、最初から最後まで示します:
- きれいな音声を録音・準備する。導入の雑談や長い無音をカットし、MP3、M4A、WAVのいずれかで書き出すか、動画の音声トラックを自動的に抽出させる。
- ファイルをアップロードし、音声認識に下書きを作らせる。話者は自動的に分離される。
- 音声と照らし合わせながら下書きをレビューし、同音異義語や抜け落ちた否定形、崩れた固有名詞を修正する。
- ケバ取りか素起こしかを決め、テキストの行き先(ショーノート、独立したトランスクリプトページ、タイムコード付きキャプション)に合わせて体裁を整える。
- ゲストの期待値と録音にまつわる権利を確認してから公開する。
アップロード前に
まずクリーンな音声から始めましょう。長い無音、言い直し、インタビューが本題に入る前の雑談は先にカットしておきます。音声が短くなれば、読むテキストも減り、後で削除する無関係な部分も減ります。
MP3、M4A、WAVのいずれかで書き出します。動画でも問題ありません。Hushscriptがブラウザ内で音声トラックを抽出するため、動画ファイル自体がアップロードされることはありませんが、すでに音声のエクスポートがあるならそちらを渡すほうが早く済みます。トラックごとに別々に文字起こししたい場合を除き、マルチトラックのセッションは先にミックスダウンしておきましょう。
ファイル名は毎回同じ形式にします:
- 録音日(フォルダが時系列順に並ぶように)
- エピソード番号
- ゲスト名またはトピック
- 複数のバージョンがある場合はバージョン番号
例えば2026-06-18-e047-jordan-chen-final.mp3のようにします。エピソードが4本のうちは些細なことに見えても、200本になったときには見つかるかどうかを分ける差になります。
下書きをレビューする
音声を再生しながらトランスクリプトを読みます。ページ上で明らかにおかしいと分かる誤りは簡単なほうです。危険な誤りは完璧に読めてしまい、実際の発言とは正反対の意味になっているもの。同音異義語、抜け落ちた否定形、崩れた固有名詞の3つが、そのまま公開されてしまう誤りです。
誤りは特定の箇所に集中する傾向があるので、集中している場所を読み込み、それ以外は流し読みで構いません。冒頭と締めくくりには名前や肩書き、口頭で読み上げられるURLが含まれます。専門的な部分には専門用語や数字が含まれます。クロストークや笑い声が生む乱れたテキストは、たいてい修正するより削除したほうがよいものです。
ついでにラベルも確認しましょう。正しく声が分かれているかを確かめ、汎用的なラベルを実名に置き換え、長い間のせいで2つに分かれてしまった話者があれば統合します。
次に、テキストをどこまで忠実にするかを決めます。ケバ取りと素起こしでは、そのトレードオフを扱っています。素起こしはすべての「えー」や言い直しをそのまま残し、ケバ取りはそれらを取り除いて文法を整えます。ほとんどのポッドキャストが求めるのは後者です。リスナーはすべての口癖を必要としませんし、ゲストもきっと内心感謝してくれるはずです。
読者のために体裁を整える
プレーンテキストの壁は、検索はできても読みにくいものです。構造を与えましょう:
- タイムスタンプを話題の変わり目、または一定の間隔で入れる
- 話者名を各発言の前に太字で入れる
- 段落分けを会話の流れが実際に変わる箇所で行う
- 見出しをエピソードの各セグメントごとに付ける
その上で、公開先に合わせて体裁を整えます。ショーノートには見出しと箇条書きが向いています。独立したトランスクリプトページには、短い導入文と再生プレーヤーへのリンクが向いています。キャプションにはSRTやVTTのようなタイムコード付きの形式が向いています。
権利、ゲスト、そして公開する内容
トランスクリプトは録音の二次的著作物なので、録音にかかる制限はたいていそのまま引き継がれます。エピソードにライセンス済みの音楽やクリップ、第三者の音声が含まれる場合は、そのテキストを公開する前に、ライセンスが実際にどこまでカバーしているかを確認しましょう。
ゲストとの期待値は、後からではなく出演承諾の段階ですり合わせておきましょう。公的な立場で発言する場合やデリケートな話題を扱う場合、公開前にトランスクリプトを確認したいと考えるゲストがいるのは当然のことです。事前に合意しておくほうが、ページが公開されてから交渉するよりずっと早く済みます。
そして公開されたトランスクリプトは、音声とは違って永続的で、公開され、引用可能なものになります。エピソードの中で未発表の研究や顧客の詳細、まだ公表していない数字に触れている場合は、公開前にレビューして該当箇所を伏せるか、そのエピソードのトランスクリプトは非公開にしておきましょう。
多言語のエピソード
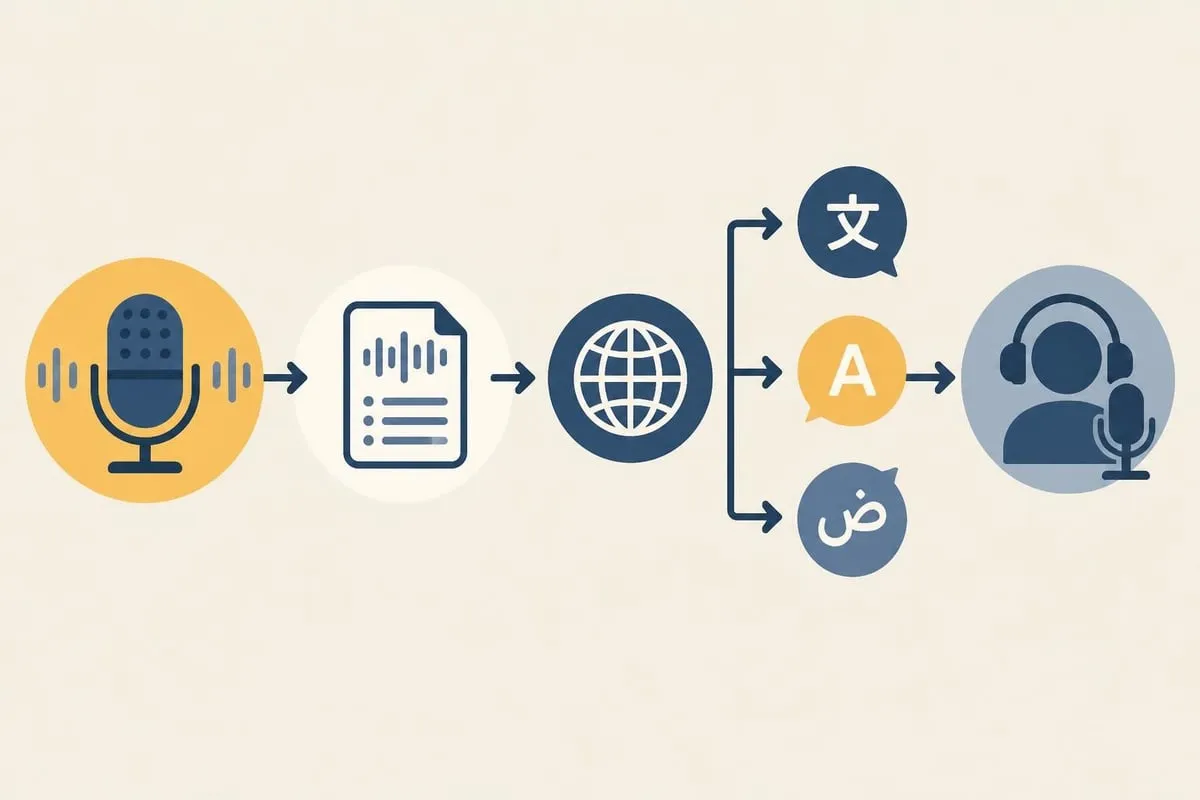
まず元の言語で文字起こしをしましょう。そうすれば、不安定な下書きから翻訳して誤りを枝分かれごとに増やすのではなく、正確なソース文書を1つ手に入れられます。Hushscriptは自動検出で約99の言語をカバーしており、翻訳先の言語を1つ追加するごとに、文字起こし自体に加えて録音時間の25%のコストがかかります。
番組の中で言語が切り替わったり、ホストがバイリンガルだったりする場合は、エピソードの途中での言語変更をサービスがどう扱うか確認しておきましょう。自動で検出するサービスもあれば、音声が届く前に言語ごとに分割しておくことを求めるサービスもあります。
破綻しない翻訳の進め方:
- 元の言語で文字起こしをして、きちんとレビューする
- 対象の言語に翻訳する
- それぞれの翻訳を母語話者に読んでもらい、トーンと言い回しを確認する
- 翻訳を元のトランスクリプトと並べて公開する
公開すべきではないエピソード
すべての録音が永続的なアーカイブにふさわしいわけではありません。個人的な話、顧客の事例研究、オフレコのセグメントは、いずれも毎週のインタビューとは違う扱いを求めます。
プライベートモードはまさにそのためにあります。音声認識自体はサービスとして実行されますが、アカウントには何も保存されません。結果はパスワードで保護された.husharchiveとしてダウンロードする形で届き、ダウンロードしなければ期限切れになります。通常のパスでは、トランスクリプトが保存された時点で文字起こし用の音声コピーは削除され、保存されたトランスクリプトの内容は保存時に暗号化され、削除するまで保持し続けるか、7、30、90、365日のいずれかで自動的に削除するかを選べます。
エクスポート形式
後からトランスクリプトで何ができるかは、そこから何が出力されるかで決まります。プレーンテキストは汎用的ですが、言葉の周りの情報をすべて失います。タイムコード付き形式はタイミング情報を保持します。構造化形式はメタデータをすべて保持します。
| 形式 | 向いている用途 | メタデータの保持 |
|---|---|---|
| TXT | アーカイブ、生テキストの貼り付け | なし |
| DOCX、PDF | データファイルを開かない相手との共有 | 一部 |
| SRT、VTT | キャプションと字幕 | タイミング |
| JSON、XML | 他のツールへの受け渡し | すべて |
| HTML | トランスクリプトをページとして公開 | 構造とスタイル |
Hushscriptは21種類の形式に加え、パスワードで保護されたアーカイブでもエクスポートできるため、どれを選んでも変換作業ではなくただのダウンロードで済みます。エピソードの動画版を公開する場合は、動画に字幕を追加する方法がタイムコード付き形式の流れを最初から最後まで解説しています。
トランスクリプトを要約ツールに読み込ませる場合、要約ツール自体よりも入力の質のほうが重要です。誤りは伝播します。トランスクリプト内の崩れた名前は、そこから作られるすべての要約、引用カード、ニュースレターの中でも崩れたままになります。
どこまでの精度が必要か
公開するポッドキャストのトランスクリプトであれば、たまの単語の誤りは文脈が補ってくれるので許容できます。一方、医療、法律、金融など人が実際に行動を起こす内容には、もっと厳密なレビューと、もっともらしい誤変換を見抜けるだけの語彙力を持つレビュアーが必要です。
推測するのではなく測定しましょう。ランダムに5分間を取り、単語数を数え、誤りの数を数え、一方をもう一方で割ります。その数値が、レビューに1時間かけるべきか10分で済むか、そして問題がサービスにあるのかマイクにあるのかを教えてくれます。
これが本当のポイントです。精度は録音の段階で決まります。どんな文字起こしサービスも、はっきりと収録されなかった言葉を復元することはできません。より静かな部屋でよいマイクを使うほうが、サービスを乗り換えるよりもトランスクリプトのためになります。
元は取れるのか
思い込みではなく、実際に計測しましょう。トランスクリプトページのページビューを見る、エピソードが扱うトピックで上位表示されているか確認する、リスナーにどうやって番組を見つけたか尋ねる。トランスクリプトはゆっくりとトラフィックを稼ぎ、エピソードがチャートから消えた後も長く稼ぎ続ける傾向があります。
天秤にかけるべきこと:
- ショーノートやSNS投稿の作成にかかる時間の節約
- トランスクリプトページに流入する検索トラフィック
- アクセシビリティと、それによって増えるリスナー
- 自分のバックカタログの検索可能なアーカイブ
- 音声ではなくテキストから始められる二次活用
文字起こしのコストは、毎月目にする明細の1項目です。一方その効果は広く分散し、遅れてやってくるため、過小評価されやすいのです。
毎週のスケジュールに耐えて生き残るワークフローは、地味なものです。クリーンな音声を入れ、機械が下書きを作り、集中したレビューを1回行い、テキストの行き先に合った形式にする。Hushscriptはその中間部分、つまりすべてのトランスクリプトへの無料の話者ラベル、約99の言語、最大10時間のアップロード、そしてサブスクリプションの代わりのプリペイド分数を担います。ポッドキャスト文字起こしページにエピソードをドロップすれば、何かを作り始める前に、最初の5分間が話者ラベル付きで返ってきます。
独立した情報源と規格
Hushscript は、競合関係にない独立した情報源を参照しています。これらは研究、規格、プラットフォームの仕組みを説明するもので、Hushscript を推奨するものではありません。
情報源の確認日: