Blog
Format transkrypcji podcastu: proces i korekta
Autor: Hushscript Opublikowano: Ostatnio sprawdzono:
Rozpoznawanie mowy w tle przygotowuje szkic transkrypcji podcastu w ułamku długości odcinka. To, co opublikujesz, zależy od łańcucha decyzji, które zapadają potem: jak dokładny ma być szkic, kto go porządkuje, jak osoby mówiące dostają imiona, w jakim formacie ląduje transkrypcja i ile z tego chcesz powtarzać co tydzień. Ustaw ten łańcuch raz dobrze, a transkrypcja podcastu kosztuje kilka minut na odcinek. Ustaw go źle, a każdy odcinek zamienia się w sesję redakcyjną, której nikt nie zaplanował.
Ta strona omawia format i cały proces. Szybkie kroki dla jednego odcinka znajdziesz w jak transkrybować podcast na tekst.
Po co robić transkrypcję podcastu
Wyszukiwarki indeksują tekst, a nie dźwięk. Transkrypcja sprawia, że ktoś może znaleźć twój odcinek po temacie, nazwisku gościa albo na wpół pamiętanej wypowiedzi, a to liczy się tym bardziej, im bardziej twój katalog wstecz rośnie poza punkt, w którym ktokolwiek go przegląda.
Drugą połową jest dostępność. Tekstu potrzebują osoby niesłyszące i słabosłyszące, ale też osoby, dla których język odcinka nie jest ojczysty, słuchające w hałasie i każdy, kto czyta szybciej, niż ty mówisz. Wytyczne Section 508 dotyczące napisów dla osób niesłyszących i słabosłyszących oraz transkrypcji traktują transkrypcję jako równoważną alternatywę dla treści wyłącznie audio i oczekują ludzkiego przeglądu automatycznego szkicu, a nie surowego zrzutu maszyny.
Czysta transkrypcja to także surowiec:
- Wpisy na blogu zbudowane z segmentu, który się wydłużył
- Cytaty do mediów społecznościowych z dokładnym brzmieniem
- Podsumowania do newslettera
- Notatki do odcinka i znaczniki rozdziałów
- Tłumaczenia dla słuchaczy, którzy lepiej czytają w danym języku, niż go słyszą
I jest archiwum. Dwa lata później możesz przeszukać własne odcinki pod kątem liczby, która padła w odcinku, historii, do której chcesz wrócić, albo uwagi gościa, którą pamiętasz tylko częściowo.
Co rozpoznawanie mowy robi dobrze, a czego nie
Automatyczne rozpoznawanie jest wystarczająco dobre, by na jego podstawie publikować, ale nie na tyle, by publikować bez czytania. Badanie mierzące dokładność rozwiązań do automatycznego rozpoznawania mowy w jedenastu usługach wykazało, że dokładność mocno różni się między dostawcami i dodatkowo spada przy użyciu strumieniowym, co jest przydatnym sprostowaniem przekonania, że transkrypcja maszynowa ma jeden stały poziom jakości.
Jakość zależy głównie od nagrania, a nie od narzędzia. Czyste audio z małym nakładaniem się głosów wygrywa z wydarzeniem na żywo z hałasem sali. Jeden prowadzący czyta się lepiej niż debata czterech osób. Codzienna rozmowa transkrybuje się czyściej niż godzina nazw leków, sygnatur spraw albo żargonu produktowego.
| Co wpływa na szkic | Jak bardzo | Co możesz zrobić |
|---|---|---|
| Jakość dźwięku | Bardzo | Nagrywaj w cichym miejscu, na prawdziwym mikrofonie |
| Ludzie mówiący jeden przez drugiego | Bardzo | Ustalcie kolejność wypowiedzi, przed przesłaniem wytnij najgorsze nakładanie się głosów |
| Akcenty i dialekty | Trochę | Wybierz usługę z mocnymi modelami wielojęzycznymi |
| Słownictwo specjalistyczne | Trochę | Wczytaj imiona i terminy do słownika przed uruchomieniem |
| Tempo mówienia | Niewiele | Normalna mowa jest w porządku; psuje się tylko bardzo szybka |
Akcenty i obsługa niepłynności mowy to dwa miejsca, w których model ogólny traci najszybciej. Jeśli w twoim programie występują goście z zagranicy, zaplanuj czas na przegląd, zamiast zakładać, że szkic jest czysty. Hushscript pozwala zapisać słownik imion, marek i powtarzającego się żargonu i zastosować go przed transkrypcją, co jest najtańszą dokładnością, jaką można kupić.
Oznaczenia osób mówiących i gdzie się mylą
Diaryzacja automatycznie rozdziela głosy i niemal zawsze poprawnie obsługuje wywiad dwóch osób. Myli się, gdy dwóch gości brzmi podobnie, gdy ludzie śmieją się jeden przez drugiego i gdy długa pauza sprawia, że jeden głos wygląda jak dwa.
Oznaczenia wracają ogólne, a zmiana nazwy jednego wystąpienia zmienia je wszędzie, więc rozmowa dwóch osób zajmuje około minuty, a panel czteroosobowy kilka. Hushscript zawiera oznaczenia osób mówiących bezpłatnie w każdej transkrypcji, bez opłaty za osobę i bez limitu głosów. Mechanikę pod spodem opisuje jak działa diaryzacja.
Wybór sposobu generowania transkrypcji
Ręcznie. Ty albo wynajęty transkrybent wpisujecie każde słowo. Najwolniej, najdrożej, najpewniej przy trudnym dźwięku. Opłaca się przy dokumentacji prawnej i medycznej, gdzie jedno złe słowo to realny problem, a przy podcaście prawie nigdy.
Hybrydowo. Szkic maszynowy, przegląd człowieka. Tu powinien trafić niemal każdy program. Maszyna pisze, a ty oceniasz: poprawiasz homofony, przywracasz pominięte przeczenie, korygujesz nazwę firmy gościa, decydujesz, ile wypełniaczy zostawić.
Surowa transkrypcja automatyczna. Prześlij, pobierz, opublikuj. W porządku do użytku wewnętrznego albo przybliżonego indeksu odcinków. Ryzykowne jako tekst publiczny, bo błędy, które zostają, to te wiarygodnie wyglądające.
Większość programów kończy na mieszance dwóch ostatnich: pełny przegląd odcinków, które promują, i nieprzejrzana transkrypcja reszty archiwum.
Płatność za użycie czy abonament
Abonament jest przewidywalny i rozlicza cię także za miesiące, w których nie publikujesz. Płatność za wykorzystane minuty rozlicza tylko wtedy, gdy transkrybujesz, co pasuje do programu sezonowego, nieregularnego harmonogramu albo wakacji.
Policz koszt na odcinek, a nie na miesiąc. Jeśli publikujesz co tydzień, abonament może wyjść taniej. Jeśli publikujesz, kiedy masz ochotę, pakiety minut opłacone z góry pozwalają z wyprzedzeniem kupić pulę minut bez przypisanego planu. Minuty nigdy nie wygasają.
Budowanie procesu
Podstawowy proces, od początku do końca:
- Nagraj i przygotuj czysty dźwięk: wytnij rozmowy przed startem i długie okresy ciszy, a następnie wyeksportuj MP3, M4A lub WAV albo pozwól, by ścieżka dźwiękowa z wideo została wyodrębniona automatycznie.
- Prześlij plik i pozwól rozpoznawaniu mowy stworzyć szkic, z automatycznie rozdzielonymi osobami mówiącymi.
- Przejrzyj szkic z nagraniem, poprawiając homofony, pominięte przeczenia i zniekształcone nazwy własne.
- Zdecyduj, czy transkrypcja wygładzona, czy dosłowna, i sformatuj tekst pod miejsce docelowe: notatki do odcinka, osobną stronę z transkrypcją albo napisy z czasem.
- Sprawdź oczekiwania gości i prawa związane z nagraniem, a potem opublikuj.
Przed przesłaniem
Zacznij od czystego audio. Wytnij długie okresy ciszy, fałszywe starty i rozmowy przed startem, zanim wywiad naprawdę się zacznie. Mniej audio to mniej tekstu do czytania i mniej nieistotnych fragmentów do usunięcia później.
Wyeksportuj MP3, M4A lub WAV. Wideo też działa, a Hushscript wyciąga ścieżkę dźwiękową w twojej przeglądarce, więc plik wideo nigdy nie jest przesyłany, ale eksport audio jest szybszy do przekazania, jeśli już go masz. Sesje wielościeżkowe najpierw zmiksuj, chyba że chcesz osobno transkrybować każdą ścieżkę.
Nazywaj pliki zawsze tak samo:
- Data nagrania, żeby folder sortował się chronologicznie
- Numer odcinka
- Imię i nazwisko gościa albo temat
- Oznaczenie wersji, jeśli istnieje więcej niż jedna
Na przykład: 2026-06-18-e047-jordan-chen-final.mp3. Błahostka przy czterech odcinkach i różnica między znalezieniem a nieznalezieniem czegoś przy dwustu.
Przegląd szkicu
Czytaj transkrypcję przy odtwarzanym nagraniu. Błędy, które źle wyglądają na stronie, są łatwe. Groźne są te, które czytają się doskonale i mówią odwrotność tego, co padło: homofony, pominięte przeczenia i zniekształcone nazwy własne to trzy rzeczy, które trafiają do publikacji.
Błędy się skupiają, więc czytaj tam, gdzie się zbierają, a resztę przeglądaj pobieżnie. Wstępy i zakończenia zawierają imiona, tytuły i wypowiedziane adresy URL. Fragmenty techniczne zawierają żargon i liczby. Nakładanie się głosów i śmiech dają bełkot, który zwykle trzeba usunąć, a nie naprawiać.
Przy okazji sprawdź oznaczenia. Potwierdź, że właściwe głosy zostały rozdzielone, zastąp ogólne oznaczenia prawdziwymi imionami i scal osobę mówiącą, która po długiej pauzie rozpadła się na dwie.
Potem zdecyduj, jak dosłowny ma być tekst. Transkrypcja wygładzona a dosłowna omawia ten kompromis: transkrypcja dosłowna zachowuje każde „yyy” i fałszywy start, wygładzona je usuwa i porządkuje gramatykę. Większość podcastów potrzebuje tej drugiej. Twoi odbiorcy nie potrzebują każdego tiku językowego, a goście po cichu ci podziękują.
Format transkrypcji podcastu dla czytelników
Ściana zwykłego tekstu da się przeszukiwać, ale nie da się jej czytać. Nadaj jej strukturę:
- Znaczniki czasu przy zmianach tematu albo w stałych odstępach
- Imiona osób mówiących wytłuszczone przed każdą wypowiedzią
- Podziały akapitów tam, gdzie rozmowa naprawdę skręca
- Nagłówki dla odrębnych segmentów odcinka
Potem sformatuj pod miejsce docelowe. Notatki do odcinka potrzebują nagłówków i punktów; poradnik krok po kroku pokazuje dla nich eksport DOCX. Osobna strona z transkrypcją potrzebuje krótkiego wstępu i linku do odtwarzacza. Napisy potrzebują formatu z czasem, takiego jak SRT lub VTT.
Prawa, goście i to, co publikujesz
Transkrypcja jest utworem zależnym od nagrania, więc ograniczenia dotyczące nagrania zwykle idą za nią. Jeśli odcinek zawiera muzykę na licencji, fragmenty albo cudze audio, sprawdź, co licencja faktycznie obejmuje, zanim opublikujesz tekst.
Oczekiwania gości ustal w formularzu zgody, a nie po fakcie. Niektórzy goście rozsądnie chcą zobaczyć transkrypcję przed publikacją, zwłaszcza gdy mówią w oficjalnym charakterze albo na drażliwy temat. Uzgodnienie tego na początku jest dużo szybsze niż negocjowanie, gdy strona już działa.
A opublikowana transkrypcja jest trwała, publiczna i cytowalna w sposób, w jaki audio nie jest. Jeśli odcinek schodzi na niepublikowane badania, dane klienta albo liczby, których jeszcze nie ogłoszono, przejrzyj go, zanim trafi do sieci, wytnij fragment albo zachowaj transkrypcję tego odcinka dla siebie.
Odcinki wielojęzyczne
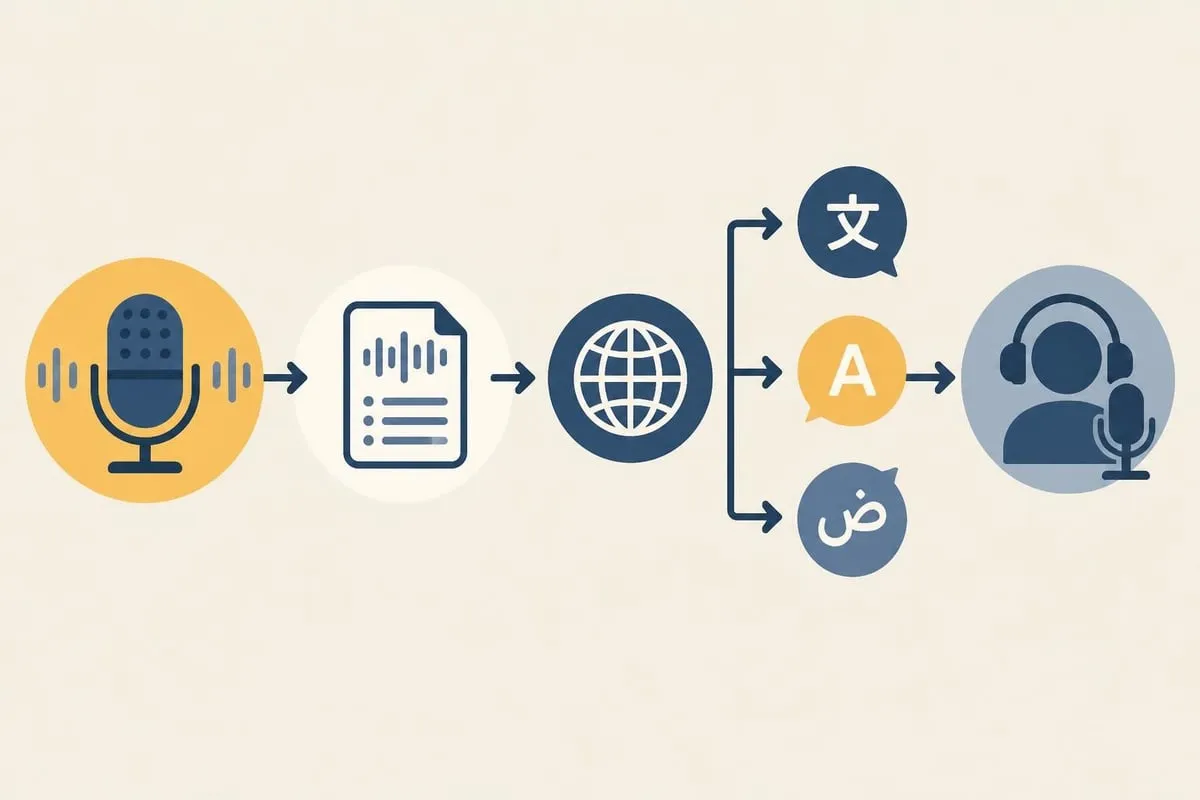
Najpierw transkrybuj w języku oryginału. Dzięki temu masz jeden dokładny dokument źródłowy, zamiast tłumaczyć z chwiejnego szkicu i mnożyć jego błędy w każdej gałęzi. Hushscript obejmuje około 99 języków mówionych z automatycznym wykrywaniem, a każdy dodany język docelowy tłumaczenia kosztuje 25% czasu trwania nagrania ponad samą transkrypcję.
Jeśli twój program przełącza języki albo prowadzący są dwujęzyczni, sprawdź, jak twoja usługa radzi sobie ze zmianą języka w środku odcinka. Niektóre ją wykrywają; inne chcą audio podzielonego na segmenty według języka, zanim do nich trafi.
Tłumaczenie, które się sprawdza:
- Transkrybuj w języku oryginału i porządnie to przejrzyj
- Przetłumacz na języki docelowe
- Poproś osobę, dla której język docelowy jest ojczysty, o przeczytanie każdego tłumaczenia pod kątem tonu i idiomów
- Opublikuj tłumaczenia obok oryginalnej transkrypcji
Odcinki, które nie powinny być publiczne
Nie każde nagranie należy do stałego archiwum. Osobiste historie, studia przypadków klientów i fragmenty nieoficjalne wymagają innego traktowania niż cotygodniowy wywiad.
Tryb prywatny jest stworzony właśnie do tego. Rozpoznawanie mowy nadal działa jako usługa, ale nic nie jest zapisywane na twoim koncie: wynik pojawia się jako chroniony hasłem .husharchive, który pobierasz, i wygasa, jeśli go nie pobierzesz. W zwykłym trybie kopia audio do transkrypcji jest usuwana po zapisaniu transkrypcji, zapisana treść transkrypcji jest szyfrowana podczas przechowywania, a ty wybierasz, czy transkrypcja jest przechowywana do czasu usunięcia, czy automatycznie usuwana po 7, 30, 90 lub 365 dniach.
Formaty eksportu transkrypcji podcastu
To, co możesz zrobić z transkrypcją potem, zależy od tego, co wychodzi z pudełka. Zwykły tekst jest uniwersalny i gubi wszystko wokół słów. Formaty z czasem niosą czas. Formaty strukturalne niosą wszystkie metadane.
| Format | Dobry do | Zachowuje metadane |
|---|---|---|
| TXT | Archiwów, wklejania surowego tekstu | Nie |
| DOCX, PDF | Udostępniania osobom, które nie otworzą pliku z danymi | Część |
| SRT, VTT | Napisów | Czas |
| JSON, XML | Zasilania innego narzędzia | Wszystkie |
| HTML | Publikowania transkrypcji jako strony | Strukturę i styl |
Hushscript eksportuje 21 formatów oraz chronione hasłem archiwum, więc wybór jednego to pobranie, a nie projekt konwersji. Jeśli publikujesz wersję wideo odcinka, dodawanie napisów do wideo opisuje ścieżkę formatów z czasem od początku do końca.
Jeśli zasilasz transkrypcjami narzędzie do streszczeń, ważniejsze jest wejście niż samo narzędzie. Błędy się przenoszą: zniekształcone imię w transkrypcji staje się zniekształconym imieniem w każdym streszczeniu, kartce z cytatem i newsletterze zbudowanym na jego podstawie.
Jak dokładnie to musi być
W opublikowanej transkrypcji podcastu pojedyncze błędne słowo jest do przeżycia, bo kontekst przeprowadza czytelnika. Treści, na podstawie których ludzie działają, medyczne, prawne czy finansowe, wymagają dokładniejszego przeglądu i recenzenta, który zna słownictwo na tyle, by wyłapać wiarygodnie wyglądającą podmianę.
Mierz zamiast zgadywać. Weź losowe pięć minut, policz słowa, policz błędy, podziel jedno przez drugie. Ta liczba mówi, czy twój przegląd zasługuje na godzinę, czy na dziesięć minut, oraz czy problemem jest usługa, czy mikrofon.
I to jest sedno: dokładność kupuje się na etapie nagrywania. Żadna usługa transkrypcji nie odzyska słów, które nigdy nie zostały wyraźnie zarejestrowane, a lepszy mikrofon w cichszym pokoju robi dla transkrypcji więcej, niż kiedykolwiek zrobi zmiana dostawcy.
Czy się opłaca
Śledź to zamiast zakładać. Obserwuj odsłony stron z transkrypcjami, sprawdzaj, czy odcinki pozycjonują się na tematy, które obejmują, i pytaj słuchaczy, jak cię znaleźli. Transkrypcje zwykle zdobywają ruch powoli i zdobywają go jeszcze długo po tym, jak odcinek zniknie z list przebojów.
Co rozważyć:
- Zaoszczędzony czas na pisaniu notatek do odcinka i postów w mediach społecznościowych
- Ruch z wyszukiwarki trafiający na strony z transkrypcjami
- Dostępność i słuchacze, których dodaje
- Przeszukiwalne archiwum własnego katalogu wstecz
- Ponowne wykorzystanie treści zaczynające się od tekstu, a nie od audio
Koszt transkrypcji to pozycja, którą widzisz co miesiąc. Korzyści są rozproszone i przychodzą późno, i właśnie dlatego łatwo je zaniżyć.
Proces, który przetrwa zderzenie z cotygodniowym harmonogramem, jest nudny: czyste audio na wejściu, szkic maszynowy, jeden skupiony przegląd, format dopasowany do miejsca, w którym tekst trafi. Hushscript obsługuje środek tego procesu, z bezpłatnymi oznaczeniami osób mówiących w każdej transkrypcji, około 99 językami, przesyłaniem do 10 godzin i minutami opłaconymi z góry zamiast abonamentu. Przeciągnij odcinek na stronę transkrypcji podcastu, a pierwsze 5 minut wróci z oznaczeniami osób mówiących, zanim utworzysz konto.
Niezależne źródła i standardy
Hushscript korzystał z tych niezależnych źródeł niezwiązanych z konkurencją. Wyjaśniają badania, standardy lub działanie platform i nie stanowią rekomendacji Hushscript.
Źródła sprawdzono: