Blog
Podcast-Transkription: der komplette Workflow
Autor: Hushscript Veröffentlicht: Zuletzt geprüft:
Einen Podcast zu transkribieren ist keine einzelne Entscheidung, sondern eine ganze Kette davon: wie genau der Entwurf sein muss, wer ihn überarbeitet, wie die Sprecher benannt werden, in welchem Format der Text am Ende vorliegt, und wie viel davon Sie bereit sind, jede Woche zu wiederholen. Stimmt die Kette einmal, kostet ein Transkript nur ein paar Minuten pro Episode. Stimmt sie nicht, wird aus jeder Episode eine Bearbeitungssitzung, die niemand eingeplant hatte.
Warum Podcaster ihre Episoden transkribieren
Suchmaschinen indexieren Text, nicht Audio. Ein Transkript ist es, was jemandem erlaubt, Ihre Episode über ein Thema, den Namen eines Gastes oder eine halb erinnerte Textzeile zu finden, und das zählt umso mehr, sobald Ihr Archiv so groß wird, dass niemand es mehr durchstöbert.
Barrierefreiheit ist die andere Hälfte davon. Gehörlose und schwerhörige Hörer brauchen den Text, ebenso Menschen, deren Muttersprache eine andere ist, Menschen in lauter Umgebung und alle, die schneller lesen, als Sie sprechen. Die Leitlinien von Section 508 zu Untertiteln und Transkripten behandeln ein Transkript als gleichwertige Alternative zu reinen Audioinhalten und erwarten dabei einen menschlichen Durchgang über den automatisierten Entwurf statt einen ungeprüften Rohauswurf der Maschine.
Ein sauberes Transkript ist auch Rohmaterial:
- Blogbeiträge aus einem Segment, das zu lang geraten ist
- Social-Media-Zitate mit dem exakten Wortlaut
- Newsletter-Zusammenfassungen
- Shownotizen und Kapitelmarken
- Übersetzungen für Hörer, die eine Sprache besser lesen als hören
Und es ist ein Archiv. Zwei Jahre später können Sie Ihre eigenen Episoden nach der Zahl durchsuchen, die Sie zitiert haben, nach der Geschichte, die Sie noch einmal hören möchten, oder nach dem Gästekommentar, an den Sie sich nur halb erinnern.
Was die Spracherkennung richtig macht und was nicht
Automatische Erkennung ist gut genug, um damit zu veröffentlichen, aber nicht gut genug, um sie ungeprüft zu veröffentlichen. Eine Studie zur Genauigkeit automatischer Spracherkennungslösungen untersuchte elf Dienste und stellte fest, dass die Genauigkeit zwischen Anbietern stark schwankt und im Streaming-Betrieb weiter sinkt, was die Vorstellung korrigiert, maschinelle Transkription sei ein einziges festes Qualitätsniveau.
Die Qualität hängt vor allem von der Aufnahme ab, nicht vom Werkzeug. Sauberes Audio mit wenig Übersprechen schlägt eine Live-Veranstaltung mit Raumgeräuschen. Ein einzelner Moderator liest sich besser als eine Debatte mit vier Stimmen. Alltägliche Gespräche transkribieren sauberer als eine Stunde voller Medikamentennamen, Aktenzeichen oder Fachjargon.
| Was den Entwurf beeinflusst | Wie stark | Was Sie dagegen tun können |
|---|---|---|
| Audioqualität | Stark | Nehmen Sie an einem ruhigen Ort auf, mit einem echten Mikrofon |
| Leute reden übereinander | Stark | Vereinbaren Sie Rederecht, schneiden Sie das schlimmste Übersprechen vor dem Upload heraus |
| Akzente und Dialekte | Etwas | Wählen Sie einen Dienst mit starken mehrsprachigen Modellen |
| Fachvokabular | Etwas | Laden Sie Namen und Begriffe vor dem Lauf in ein Wörterbuch |
| Sprechtempo | Wenig | Normales Tempo ist unproblematisch; nur sehr schnelles Sprechen verschlechtert das Ergebnis |
Akzente und der Umgang mit Sprechunregelmäßigkeiten sind die beiden Stellen, an denen ein generisches Modell am schnellsten an Genauigkeit verliert. Wenn in Ihrer Sendung internationale Gäste auftreten, planen Sie Zeit für die Überarbeitung ein, statt anzunehmen, der Entwurf sei bereits sauber. Mit Hushscript können Sie ein Wörterbuch aus Namen, Marken und wiederkehrendem Fachjargon speichern und es vor der Transkription anwenden. Das ist die günstigste Genauigkeit, die Sie kaufen können.
Sprecherbeschriftung und wo sie ins Straucheln gerät
Die Diarisierung trennt Stimmen automatisch und liegt bei einem Interview mit zwei Personen fast immer richtig. Sie strauchelt, wenn zwei Gäste ähnlich klingen, wenn Leute übereinander lachen, oder wenn eine lange Pause eine Stimme wie zwei aussehen lässt.
Die Beschriftungen kommen zunächst generisch zurück, und das Umbenennen einer Instanz benennt sie überall um, sodass ein Zweiergespräch etwa eine Minute zum Benennen braucht und ein Panel mit vier Personen ein paar Minuten. Hushscript enthält die Sprecherbeschriftung kostenlos in jedem Transkript, ohne Gebühr pro Sprecher und ohne Obergrenze für die Anzahl der Stimmen. Wie das im Detail funktioniert, zeigt Funktionsweise der Sprecherdiarisierung.
Den richtigen Ansatz wählen
Manuell. Sie selbst oder eine beauftragte Schreibkraft tippen jedes Wort. Am langsamsten, am teuersten, am zuverlässigsten bei schwierigem Audio. Das lohnt sich bei juristischen und medizinischen Aufzeichnungen, wo ein falsches Wort ein echtes Problem ist, aber fast nie bei einem Podcast.
Hybrid. Maschineller Entwurf, menschliche Überprüfung. Hier sollten fast alle Sendungen landen. Die Maschine übernimmt das Tippen, Sie übernehmen die Beurteilung: Homophone korrigieren, eine verlorene Verneinung wiederherstellen, den Firmennamen des Gastes berichtigen, entscheiden, wie viel Füllmaterial stehen bleibt.
Roh automatisiert. Hochladen, herunterladen, veröffentlichen. In Ordnung für den internen Gebrauch oder einen groben Episodenindex. Riskant als öffentlicher Text, weil gerade die Fehler überleben, die plausibel aussehen.
Die meisten Sendungen landen bei einer Mischung aus den letzten beiden: ein vollständiger Korrekturdurchgang für die Episoden, die aktiv beworben werden, und ein ungeprüftes Transkript für den Rest des Archivs.
Pay-as-you-go oder Abonnement
Ein Abonnement ist planbar und berechnet Ihnen auch die Monate, in denen Sie nichts veröffentlichen. Pay-as-you-go berechnet nur, wenn Sie transkribieren, was zu einer saisonalen Sendung, einem unregelmäßigen Rhythmus oder einer Sommerpause passt.
Rechnen Sie die Kosten pro Episode statt pro Monat durch. Wenn Sie wöchentlich veröffentlichen, kann ein Abonnement günstiger ausfallen. Wenn Sie veröffentlichen, wann immer Sie möchten, lassen vorausbezahlte Minutenpakete Sie Kapazität im Voraus kaufen, ohne einen Plan daran zu binden. Minuten bleiben 365 Tage gültig, und jede abgeschlossene Transkription oder jeder neue Kauf setzt dieses Zeitfenster zurück.
Den Workflow aufbauen
Der Kernworkflow, von Anfang bis Ende:
- Sauberes Audio aufnehmen und vorbereiten: das Vorgeplänkel und lange Stillen herausschneiden, dann als MP3, M4A oder WAV exportieren, oder die Tonspur eines Videos automatisch extrahieren lassen.
- Die Datei hochladen und die Spracherkennung den Entwurf erstellen lassen, mit automatisch getrennten Sprechern.
- Den Entwurf anhand des Audios prüfen und Homophone, verlorene Verneinungen und verstümmelte Eigennamen korrigieren.
- Entscheiden, ob bereinigt oder wortgetreu, und den Text für das jeweilige Ziel formatieren: Shownotizen, eine eigenständige Transkriptseite oder zeitgesteuerte Untertitel.
- Die Erwartungen der Gäste und etwaige Rechte an der Aufnahme prüfen, dann veröffentlichen.
Vor dem Upload
Starten Sie mit sauberem Audio. Schneiden Sie lange Stille, Fehlstarts und das Vorgeplänkel heraus, bevor das eigentliche Interview beginnt. Weniger Audio bedeutet weniger Text zum Lesen und weniger irrelevante Passagen, die Sie später löschen müssen.
Exportieren Sie MP3, M4A oder WAV. Video funktioniert auch. Hushscript zieht die Tonspur in Ihrem Browser heraus, sodass die Videodatei nie hochgeladen wird, aber ein Audioexport ist schneller zur Hand, wenn Sie bereits einen haben. Mischen Sie Mehrspur-Sitzungen zuerst ab, außer Sie möchten gezielt jede Spur getrennt transkribiert haben.
Benennen Sie die Dateien jedes Mal auf die gleiche Weise:
- Das Aufnahmedatum, damit sich der Ordner chronologisch sortiert
- Die Episodennummer
- Der Gastname oder das Thema
- Eine Versionsmarkierung, falls mehr als ein Schnitt existiert
Zum Beispiel: 2026-06-18-e047-jordan-chen-final.mp3. Bei vier Episoden ist das nebensächlich, aber der Unterschied zwischen Finden und Nichtfinden, sobald Sie zweihundert haben.
Den Entwurf überprüfen
Lesen Sie das Transkript, während das Audio läuft. Fehler, die auf der Seite falsch aussehen, sind die einfachen. Die gefährlichen Fehler lesen sich einwandfrei und sagen das Gegenteil von dem, was gesagt wurde: Homophone, verlorene Verneinungen und verstümmelte Eigennamen sind die drei, die es bis zur Veröffentlichung schaffen.
Fehler häufen sich, lesen Sie also dort genau, wo sie sich sammeln, und überfliegen Sie den Rest. Intros und Outros tragen Namen, Titel und gesprochene URLs. Technische Passagen tragen Fachjargon und Zahlen. Übersprechen und Lachen erzeugen Unsinn, der meist gelöscht statt repariert werden will.
Prüfen Sie dabei gleich die Beschriftungen. Bestätigen Sie, dass die richtigen Stimmen sauber getrennt wurden, ersetzen Sie die generischen Beschriftungen durch echte Namen, und führen Sie jeden Sprecher zusammen, der nach einer langen Pause in zwei aufgespalten wurde.
Entscheiden Sie dann, wie wörtlich der Text sein soll. Bereinigt vs. wortgetreu behandelt diesen Kompromiss: Wortgetreu behält jedes Äh und jeden Fehlstart, bereinigt entfernt sie und glättet die Grammatik. Die meisten Podcasts wollen Zweiteres. Ihr Publikum braucht nicht jeden verbalen Tick, und Ihre Gäste werden es Ihnen stillschweigend danken.
Formatierung für Leser
Eine Wand aus reinem Text ist durchsuchbar und unlesbar. Geben Sie ihr Struktur:
- Zeitstempel bei Themenwechseln oder in festen Abständen
- Sprechernamen fett gesetzt vor jedem Redebeitrag
- Absatzumbrüche dort, wo sich das Gespräch tatsächlich wendet
- Überschriften für die einzelnen Abschnitte der Episode
Formatieren Sie dann für das jeweilige Ziel. Shownotizen wollen Überschriften und Aufzählungspunkte. Eine eigenständige Transkriptseite will eine kurze Einleitung und einen Link zum Player. Untertitel wollen ein zeitgesteuertes Format wie SRT oder VTT.
Rechte, Gäste und was Sie veröffentlichen
Ein Transkript ist ein Derivat der Aufnahme, daher gelten die Einschränkungen der Aufnahme in der Regel auch für das Transkript. Wenn eine Episode lizenzierte Musik, Clips oder fremdes Audiomaterial enthält, prüfen Sie, was die Lizenz tatsächlich abdeckt, bevor Sie den Text davon veröffentlichen.
Klären Sie die Erwartungen der Gäste in der Freigabe, nicht erst hinterher. Manche Gäste möchten das Transkript verständlicherweise vor der Veröffentlichung sehen, besonders wenn sie in offizieller Funktion oder zu einem sensiblen Thema sprechen. Das im Voraus zu vereinbaren, ist deutlich schneller, als es zu verhandeln, sobald die Seite bereits live ist.
Und ein veröffentlichtes Transkript ist dauerhaft, öffentlich und zitierbar auf eine Weise, wie Audio es nicht ist. Wenn eine Episode in unveröffentlichte Forschung, Kundendetails oder noch nicht angekündigte Zahlen abdriftet, prüfen Sie sie, bevor sie online geht, schwärzen Sie die betreffende Passage, oder behalten Sie das Transkript dieser Episode für sich.
Mehrsprachige Episoden
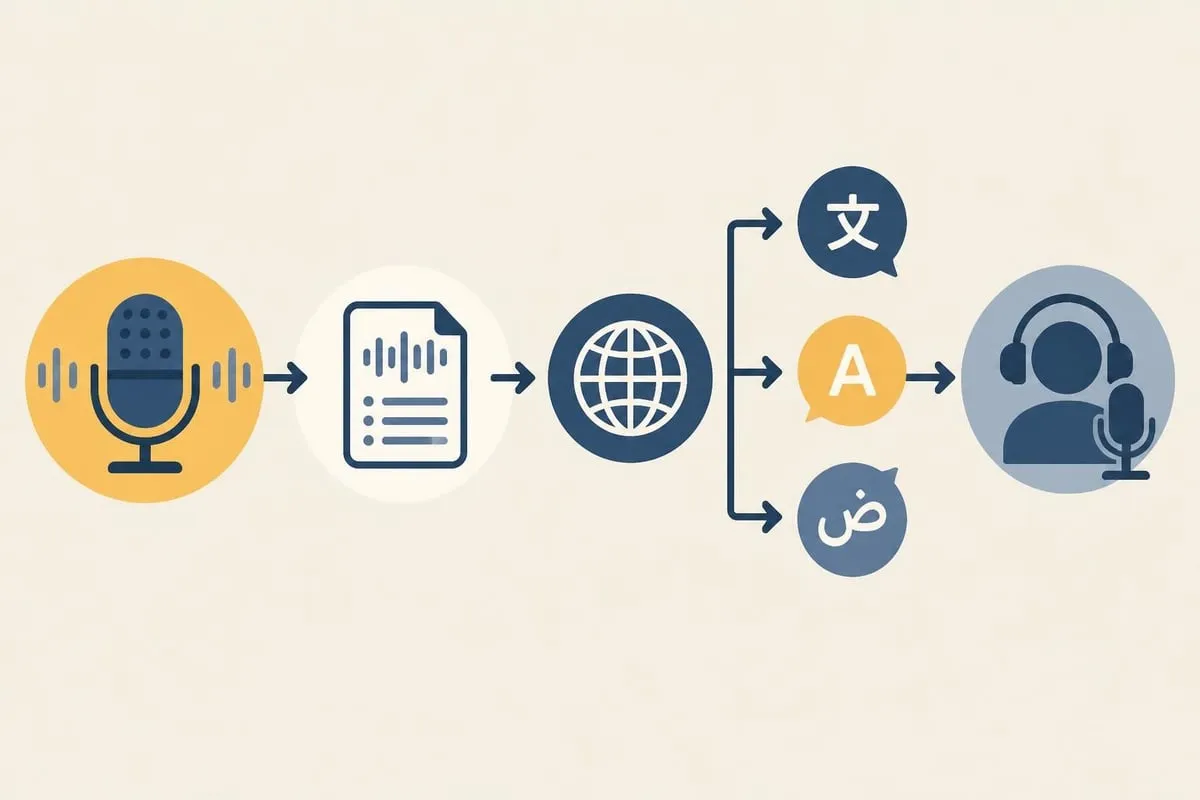
Transkribieren Sie zuerst in der Originalsprache. Das gibt Ihnen ein genaues Ausgangsdokument, statt von einem wackligen Entwurf aus zu übersetzen und dessen Fehler in jeden Zweig zu vervielfachen. Hushscript deckt mit automatischer Erkennung etwa 99 gesprochene Sprachen ab, und jede zusätzliche Zielsprache kostet 25 % der Aufnahmedauer zusätzlich zur eigentlichen Transkription.
Wenn in Ihrer Sendung zwischen Sprachen gewechselt wird oder Ihre Moderatoren zweisprachig sind, prüfen Sie, wie Ihr Dienst einen Sprachwechsel mitten in der Episode behandelt. Manche erkennen ihn automatisch, andere wollen das Audio schon vorab nach Sprache segmentiert haben.
Ein Übersetzungsdurchgang, der hält:
- Die Originalsprache transkribieren und gründlich überprüfen
- In die Zielsprachen übersetzen
- Jede Übersetzung von einem Muttersprachler auf Tonfall und Idiomatik prüfen lassen
- Die Übersetzungen zusammen mit dem Originaltranskript veröffentlichen
Episoden, die nicht öffentlich sein sollten
Nicht jede Aufnahme gehört in ein dauerhaftes Archiv. Persönliche Geschichten, Kundenfallstudien und Passagen unter der Hand sprechen alle für eine andere Handhabung als das wöchentliche Interview.
Der private Modus ist genau dafür gemacht. Die Spracherkennung läuft weiterhin als Dienst, aber nichts wird in Ihrem Konto gespeichert: Das Ergebnis kommt als passwortgeschütztes .husharchive an, das Sie herunterladen, und es läuft ab, wenn Sie das nie tun. Auf dem normalen Weg wird die Audiokopie der Transkription entfernt, sobald das Transkript gespeichert ist, gespeicherte Transkriptinhalte werden verschlüsselt abgelegt, und Sie entscheiden, ob ein Transkript bestehen bleibt, bis Sie es löschen, oder ob es nach 7, 30, 90 oder 365 Tagen automatisch gelöscht wird.
Exportformate
Was Sie später mit einem Transkript anfangen können, hängt davon ab, was von Anfang an dabei ist. Reiner Text ist universell und verliert alles rund um die Worte. Zeitgesteuerte Formate tragen die Zeitangaben. Strukturierte Formate tragen alle Metadaten.
| Format | Gut für | Behält Metadaten |
|---|---|---|
| TXT | Archive, rohen Text einfügen | Nein |
| DOCX, PDF | Teilen mit Leuten, die keine Datendatei öffnen werden | Teilweise |
| SRT, VTT | Untertitel | Zeitangaben |
| JSON, XML | Als Eingabe für ein anderes Tool | Alle |
| HTML | Das Transkript als Seite veröffentlichen | Struktur und Gestaltung |
Hushscript exportiert 21 Formate plus ein passwortgeschütztes Archiv, sodass die Wahl eines Formats ein Download ist und kein Konvertierungsprojekt. Wenn Sie einen Videoschnitt der Episode veröffentlichen, deckt So fügen Sie einem Video Untertitel hinzu den zeitgesteuerten Weg von Anfang bis Ende ab.
Wenn Sie Transkripte in einen Zusammenfasser einspeisen, zählt die Eingabe mehr als der Zusammenfasser selbst. Fehler pflanzen sich fort: Ein verstümmelter Name im Transkript wird zu einem verstümmelten Namen in jeder Zusammenfassung, jeder Zitatkarte und jedem Newsletter, der darauf aufbaut.
Wie genau muss es sein
Bei einem veröffentlichten Podcast-Transkript ist das gelegentliche falsche Wort verkraftbar, weil der Kontext den Leser darüber hinwegträgt. Inhalte, nach denen Menschen handeln, medizinisch, juristisch oder finanziell, brauchen einen strengeren Durchgang und einen Prüfer, der das Vokabular gut genug kennt, um eine plausible Verwechslung zu erkennen.
Messen Sie, statt zu raten. Nehmen Sie fünf beliebige Minuten, zählen Sie die Wörter, zählen Sie die Fehler, teilen Sie das eine durch das andere. Diese Zahl sagt Ihnen, ob Ihr Korrekturdurchgang eine Stunde oder zehn Minuten verdient, und ob Ihr Problem beim Dienst oder beim Mikrofon liegt.
Und das ist der eigentliche Punkt: Genauigkeit wird bei der Aufnahme erkauft. Kein Transkriptionsdienst rekonstruiert Worte, die nie klar eingefangen wurden, und ein besseres Mikrofon in einem ruhigeren Raum bringt dem Transkript mehr als jeder Anbieterwechsel je könnte.
Lohnt es sich
Verfolgen Sie es, statt es anzunehmen. Beobachten Sie die Seitenaufrufe der Transkriptseiten, prüfen Sie, ob Episoden für die Themen ranken, die sie behandeln, und fragen Sie Hörer, wie sie zu Ihnen gefunden haben. Transkripte bringen Traffic meist langsam, aber sie bringen ihn noch lange, nachdem eine Episode aus den Charts gefallen ist.
Was Sie abwägen sollten:
- Zeitersparnis beim Schreiben von Shownotizen und Social-Media-Beiträgen
- Suchtraffic, der auf Transkriptseiten landet
- Barrierefreiheit und die Hörer, die sie hinzugewinnt
- Ein durchsuchbares Archiv Ihres eigenen Backkatalogs
- Weiterverwertung, die von Text statt von Audio ausgeht
Die Kosten der Transkription sind ein Posten, den Sie jeden Monat sehen. Der Nutzen ist diffus und kommt spät an, und genau deshalb wird er so leicht unterschätzt.
Der Workflow, der einen wöchentlichen Zeitplan tatsächlich übersteht, ist der langweilige: sauberes Audio rein, maschineller Entwurf, ein fokussierter Korrekturdurchgang, ein Format, das zum jeweiligen Ziel passt. Hushscript übernimmt die Mitte davon, mit kostenloser Sprecherbeschriftung auf jedem Transkript, etwa 99 Sprachen, Uploads bis zu 10 Stunden und vorausbezahlten Minuten statt eines Abonnements. Legen Sie eine Episode auf der Seite Podcast-Transkription ab, und die ersten 5 Minuten kommen sprecherbeschriftet zurück, bevor Sie irgendetwas anlegen.
Unabhängige Quellen und Standards
Hushscript hat diese unabhängigen, nicht konkurrierenden Quellen herangezogen. Sie erläutern Forschung, Standards oder Plattformfunktionen und stellen keine Empfehlung durch Hushscript dar.
Quellen geprüft am: