Blog
Transcrire un podcast, de bout en bout
Auteur : Hushscript Publié le : Dernière révision :
Transcrire un podcast n’est pas une seule décision, c’est une chaîne de décisions : quelle précision veut le brouillon, qui le relit, comment les locuteurs sont nommés, dans quel format le texte finit, et combien de cela vous acceptez de répéter chaque semaine. Réglez bien cette chaîne une fois et une transcription coûte quelques minutes par épisode. Réglez-la mal et chaque épisode devient une séance de retouche que personne n’avait prévue.
Pourquoi les podcasteurs transcrivent leurs épisodes
Les moteurs de recherche indexent le texte, pas l’audio. Une transcription est ce qui permet de retrouver votre épisode par un sujet, le nom d’un invité ou une phrase à moitié oubliée, et cela compte d’autant plus dès que votre catalogue devient trop grand pour que quiconque le parcoure.
L’accessibilité est l’autre moitié de l’équation. Les auditeurs sourds et malentendants ont besoin du texte, tout comme les personnes qui ne sont pas de langue maternelle, celles qui écoutent dans un endroit bruyant, et quiconque lit plus vite qu’il ne parle. Les recommandations de la Section 508 sur les sous-titres et les transcriptions traitent une transcription comme l’équivalent d’un contenu audio seul, et elles attendent une relecture humaine du brouillon automatisé plutôt qu’un simple export brut de la machine.
Une transcription propre est aussi une matière première :
- Des articles de blog tirés d’un passage qui a duré plus longtemps que prévu
- Des citations pour les réseaux sociaux avec la formulation exacte
- Des résumés de newsletter
- Des notes d’épisode et des repères de chapitres
- Des traductions pour les auditeurs qui lisent une langue mieux qu’ils ne l’entendent
Et c’est aussi une archive. Deux ans plus tard, vous pouvez fouiller vos propres épisodes pour retrouver le chiffre que vous avez cité, l’histoire que vous voulez revoir, ou la remarque d’un invité dont vous ne vous souvenez qu’à moitié.
Ce que la reconnaissance vocale réussit, et ce qu’elle ne réussit pas
La reconnaissance automatique est assez bonne pour publier à partir d’elle, mais pas assez bonne pour publier sans relecture. Une étude mesurant la précision des solutions de reconnaissance vocale automatique sur onze services a constaté que la précision varie fortement d’un fournisseur à l’autre et se dégrade encore en usage en continu, ce qui corrige utilement l’idée que la transcription automatique n’aurait qu’un seul niveau de qualité fixe.
La qualité dépend surtout de l’enregistrement, pas de l’outil. Un audio propre avec peu de diaphonie l’emporte sur un événement en direct avec du bruit de salle. Un animateur seul se transcrit mieux qu’un débat à quatre voix. Une conversation ordinaire se transcrit plus proprement qu’une heure de noms de médicaments, de citations juridiques ou de jargon produit.
| Ce qui affecte le brouillon | À quel point | Ce que vous pouvez y faire |
|---|---|---|
| Qualité audio | Beaucoup | Enregistrez dans un endroit calme, avec un vrai microphone |
| Les gens qui se coupent la parole | Beaucoup | Mettez-vous d’accord sur les tours de parole, coupez la pire diaphonie avant de téléverser |
| Accents et dialectes | Un peu | Choisissez un service avec de solides modèles multilingues |
| Vocabulaire spécialisé | Un peu | Chargez les noms et les termes dans un dictionnaire avant l’exécution |
| Débit de parole | Très peu | Un débit normal ne pose pas de problème ; seul un débit très rapide dégrade le résultat |
Les accents et la gestion des hésitations sont les deux points où un modèle générique perd le plus vite du terrain. Si votre émission reçoit des invités internationaux, prévoyez du temps de relecture plutôt que de supposer que le brouillon est propre. Hushscript vous permet d’enregistrer un dictionnaire de noms, de marques et de jargon récurrent et de l’appliquer avant la transcription, ce qui est la précision la moins chère que vous puissiez acheter.
Les étiquettes de locuteurs, et où elles dérapent
La diarisation sépare les voix automatiquement et réussit un entretien à deux quasiment à chaque fois. Elle dérape quand deux invités ont une voix similaire, quand les gens rient en même temps, et quand une longue pause fait ressembler une seule voix à deux.
Les étiquettes reviennent génériques, et renommer une occurrence la renomme partout, si bien qu’un duo prend environ une minute à nommer et un panel de quatre personnes en prend quelques-unes. Hushscript inclut gratuitement les étiquettes de locuteurs sur chaque transcription, sans frais par locuteur ni plafond sur le nombre de voix. Pour les mécanismes sous-jacents, consultez comment fonctionne la diarisation des locuteurs.
Choisir une approche
Manuelle. Vous, ou un transcripteur engagé, tapez chaque mot. La plus lente, la plus chère, la plus fiable sur un audio difficile. Elle justifie son coût sur des dossiers juridiques et médicaux où un mot faux est un vrai problème, et presque jamais sur un podcast.
Hybride. Un brouillon machine, une relecture humaine. C’est là que devrait atterrir presque toute émission. La machine fait la frappe et vous faites le jugement : corriger les homophones, rétablir une négation manquante, corriger le nom de l’entreprise de l’invité, décider combien de mots de remplissage laisser.
Automatisée brute. Téléverser, télécharger, publier. Très bien pour un usage interne ou un index approximatif des épisodes. Risquée comme texte public, car les erreurs qui survivent sont celles qui ont l’air plausibles.
La plupart des émissions finissent par mélanger les deux dernières : une relecture complète sur les épisodes qu’elles mettent en avant, et une transcription non relue sur le reste de l’archive.
Paiement à la minute ou abonnement
Un abonnement est prévisible et vous facture même les mois où vous ne publiez rien. Le paiement à la minute ne vous facture que lorsque vous transcrivez, ce qui convient à une émission saisonnière, un calendrier irrégulier, ou une pause estivale.
Calculez le coût par épisode plutôt que par mois. Si vous publiez chaque semaine, un abonnement peut revenir moins cher. Si vous publiez quand l’envie vous prend, les packs de minutes prépayées vous permettent d’acheter de la capacité à l’avance, sans engagement. Les minutes restent valables 365 jours, et toute transcription terminée ou tout nouvel achat réinitialise la fenêtre.
Construire le flux de travail
Le flux de travail complet, de bout en bout :
- Enregistrez et préparez un audio propre : coupez le bavardage d’installation et les longs silences, puis exportez en MP3, M4A ou WAV, ou laissez la piste audio d’une vidéo s’extraire automatiquement.
- Téléversez le fichier et laissez la reconnaissance vocale produire le brouillon, avec les locuteurs séparés automatiquement.
- Relisez le brouillon en suivant l’audio, en corrigeant les homophones, les négations disparues et les noms propres estropiés.
- Choisissez verbatim épuré ou verbatim intégral, et mettez le texte en forme selon sa destination : notes d’épisode, page de transcription autonome ou sous-titres chronométrés.
- Vérifiez les attentes de l’invité et les droits liés à l’enregistrement, puis publiez.
Avant de téléverser
Partez d’un audio propre. Coupez les longs silences, les faux départs et le bavardage d’installation avant que l’entretien ne commence vraiment. Moins d’audio veut dire moins de texte à lire et moins de passages inutiles à supprimer plus tard.
Exportez en MP3, M4A ou WAV. La vidéo fonctionne aussi, et Hushscript extrait la piste audio dans votre navigateur si bien que le fichier vidéo n’est jamais téléversé, mais un export audio est plus rapide à transmettre si vous en avez déjà un. Mixez d’abord les sessions multipistes, sauf si vous voulez spécifiquement que chaque piste soit transcrite séparément.
Nommez les fichiers de la même façon à chaque fois :
- La date de l’enregistrement, pour que le dossier se classe chronologiquement
- Le numéro de l’épisode
- Le nom de l’invité ou le sujet
- Un repère de version, s’il existe plus d’un montage
Par exemple : 2026-06-18-e047-jordan-chen-final.mp3. Anodin quand vous avez quatre épisodes, et la différence entre trouver et ne pas trouver quelque chose une fois que vous en avez deux cents.
Relire le brouillon
Lisez la transcription pendant que l’audio joue. Les erreurs qui ont l’air fausses sur la page sont les faciles. Les erreurs dangereuses se lisent parfaitement et disent le contraire de ce qui a été dit : les homophones, les négations disparues et les noms propres estropiés sont les trois qui finissent publiées.
Les erreurs se regroupent, donc lisez là où elles s’accumulent et survolez le reste. Les intros et les outros portent des noms, des titres et des URL prononcées à voix haute. Les passages techniques portent du jargon et des chiffres. La diaphonie et les rires produisent du bruit qu’il vaut généralement mieux supprimer que réparer.
Vérifiez les étiquettes pendant que vous y êtes. Confirmez que les bonnes voix ont été bien séparées, remplacez les étiquettes génériques par de vrais noms, et fusionnez tout locuteur qui aurait été scindé en deux après une longue pause.
Décidez ensuite à quel point le texte doit être littéral. Verbatim épuré et verbatim intégral traite ce compromis : le verbatim intégral garde chaque « euh » et chaque faux départ, le verbatim épuré les retire et arrange la grammaire. La plupart des podcasts veulent le second. Votre public n’a pas besoin de chaque tic verbal, et vos invités vous en remercieront discrètement.
Mettre en forme pour les lecteurs
Un mur de texte brut est consultable mais illisible. Donnez-lui une structure :
- Des horodatages aux changements de sujet, ou à intervalle fixe
- Les noms des locuteurs en gras avant chaque tour de parole
- Des retours à la ligne là où la conversation change réellement de direction
- Des titres pour les segments distincts de l’épisode
Adaptez ensuite la mise en forme à la destination. Les notes d’épisode veulent des titres et des puces. Une page de transcription autonome veut une courte intro et un lien vers le lecteur. Les sous-titres veulent un format chronométré comme SRT ou VTT.
Droits, invités, et ce que vous publiez
Une transcription est un dérivé de l’enregistrement, si bien que les restrictions qui s’appliquent à l’enregistrement ont tendance à la suivre. Si un épisode contient de la musique sous licence, des extraits, ou de l’audio tiers, vérifiez ce que la licence couvre réellement avant d’en publier le texte.
Réglez les attentes de l’invité au moment de la publication plutôt qu’après. Certains invités souhaitent raisonnablement voir la transcription avant publication, en particulier lorsqu’ils s’expriment à titre officiel ou sur un sujet sensible. S’entendre sur ce point en amont est bien plus rapide que de le négocier une fois la page en ligne.
Et une transcription publiée est permanente, publique, et citable d’une façon que l’audio n’est pas. Si un épisode s’aventure dans une recherche non publiée, un détail client, ou des chiffres que vous n’avez pas annoncés, relisez-le avant sa mise en ligne, caviardez le passage, ou gardez la transcription de cet épisode pour vous.
Épisodes multilingues
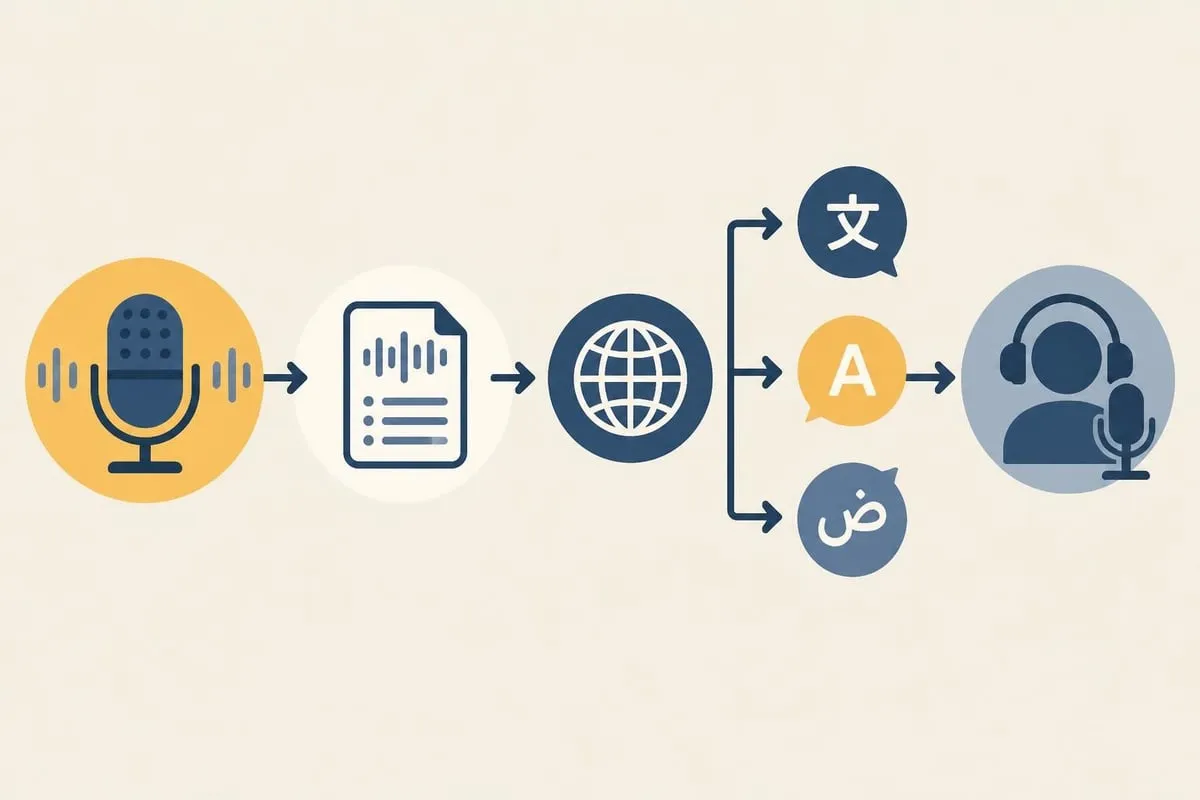
Transcrivez d’abord dans la langue d’origine. Vous obtenez ainsi un seul document source précis, plutôt que de traduire à partir d’un brouillon bancal et de multiplier ses erreurs à chaque branche. Hushscript couvre environ 99 langues parlées avec détection automatique, et chaque langue de traduction ajoutée coûte 25 % de la durée de l’enregistrement en plus de la transcription elle-même.
Si votre émission alterne les langues, ou que vos animateurs sont bilingues, vérifiez comment votre service gère un changement de langue en cours d’épisode. Certains le détectent ; d’autres veulent que l’audio soit segmenté par langue avant d’arriver.
Un processus de traduction qui tient la route :
- Transcrivez la langue d’origine et relisez-la correctement
- Traduisez vers les langues cibles
- Faites relire chaque traduction par un locuteur natif pour le ton et les tournures
- Publiez les traductions à côté de la transcription originale
Les épisodes qui ne devraient pas être publics
Tous les enregistrements n’ont pas leur place dans une archive permanente. Les histoires personnelles, les études de cas clients et les passages hors-antenne appellent tous un traitement différent de celui de l’entretien hebdomadaire.
Le mode privé est conçu exactement pour cela. La reconnaissance vocale s’exécute toujours comme un service, mais rien n’est enregistré sur votre compte : le résultat arrive sous la forme d’une .husharchive protégée par mot de passe que vous téléchargez, et elle expire si vous ne le faites jamais. Sur le chemin normal, la copie audio de la transcription est supprimée une fois la transcription enregistrée, le contenu de la transcription stocké est chiffré au repos, et vous choisissez si une transcription est conservée jusqu’à ce que vous la supprimiez ou automatiquement supprimée après 7, 30, 90 ou 365 jours.
Formats d’export
Ce que vous pouvez faire d’une transcription par la suite dépend de ce qui en sort par défaut. Le texte brut est universel et perd tout ce qui entoure les mots. Les formats chronométrés conservent le minutage. Les formats structurés conservent toutes les métadonnées.
| Format | Utile pour | Conserve les métadonnées |
|---|---|---|
| TXT | Archives, coller du texte brut | Non |
| DOCX, PDF | Partager avec des personnes qui n’ouvriront pas un fichier de données | Un peu |
| SRT, VTT | Sous-titres et légendes | Minutage |
| JSON, XML | Alimenter un autre outil | Toutes |
| HTML | Publier la transcription comme une page | Structure et mise en forme |
Hushscript exporte 21 formats plus une archive protégée par mot de passe, si bien que choisir l’un d’eux relève d’un simple téléchargement plutôt que d’un projet de conversion. Si vous publiez un montage vidéo de l’épisode, comment ajouter des sous-titres à une vidéo couvre de bout en bout le chemin des formats chronométrés.
Si vous injectez des transcriptions dans un outil de résumé, l’entrée compte plus que l’outil lui-même. Les erreurs se propagent : un nom écorché dans la transcription devient un nom écorché dans chaque résumé, chaque citation visuelle et chaque newsletter construits par-dessus.
Quel niveau de précision est nécessaire
Pour une transcription de podcast publiée, un mot faux de temps en temps reste supportable, car le contexte porte le lecteur au-dessus. Un contenu sur lequel les gens agissent, médical, juridique ou financier, a besoin d’une relecture plus serrée et d’un relecteur qui connaît assez bien le vocabulaire pour repérer une substitution plausible.
Mesurez plutôt que de deviner. Prenez cinq minutes au hasard, comptez les mots, comptez les erreurs, divisez l’un par l’autre. Ce chiffre vous dit si votre relecture mérite une heure ou dix minutes, et si votre problème vient du service ou du microphone.
Ce qui est le vrai point : la précision s’achète à l’étape de l’enregistrement. Aucun service de transcription ne récupère des mots qui n’ont jamais été clairement captés, et un meilleur microphone dans une pièce plus calme fait plus pour la transcription que changer de fournisseur ne le fera jamais.
Est-ce que ça rapporte
Suivez-le plutôt que de le supposer. Surveillez les vues de page sur les pages de transcription, vérifiez si les épisodes se classent pour les sujets qu’ils couvrent, et demandez aux auditeurs comment ils vous ont trouvé. Les transcriptions ont tendance à gagner du trafic lentement et à continuer d’en gagner longtemps après qu’un épisode soit sorti des classements.
Ce qu’il faut peser :
- Le temps gagné à rédiger les notes d’épisode et les publications sur les réseaux sociaux
- Le trafic de recherche qui atterrit sur les pages de transcription
- L’accessibilité, et les auditeurs qu’elle ajoute
- Une archive consultable de votre propre catalogue
- Une réutilisation qui part du texte plutôt que de l’audio
Le coût de la transcription est une ligne que vous voyez chaque mois. Les bénéfices sont diffus et arrivent tard, ce qui explique exactement pourquoi ils sont faciles à sous-estimer.
Le flux de travail qui survit au contact d’un calendrier hebdomadaire est le plus ennuyeux : un audio propre en entrée, un brouillon machine, une relecture ciblée, un format adapté à la destination du texte. Hushscript gère le milieu de ce processus, avec des étiquettes de locuteurs gratuites sur chaque transcription, environ 99 langues, des téléversements jusqu’à 10 heures, et des minutes prépayées au lieu d’un abonnement. Déposez un épisode sur la page transcription de podcast et les 5 premières minutes reviennent étiquetées par locuteur avant que vous ne créiez de compte.
Sources et normes indépendantes
Hushscript a consulté ces références indépendantes et non concurrentes. Elles présentent des recherches, des normes ou le fonctionnement de plateformes et ne constituent pas une recommandation de Hushscript.
Sources vérifiées le :